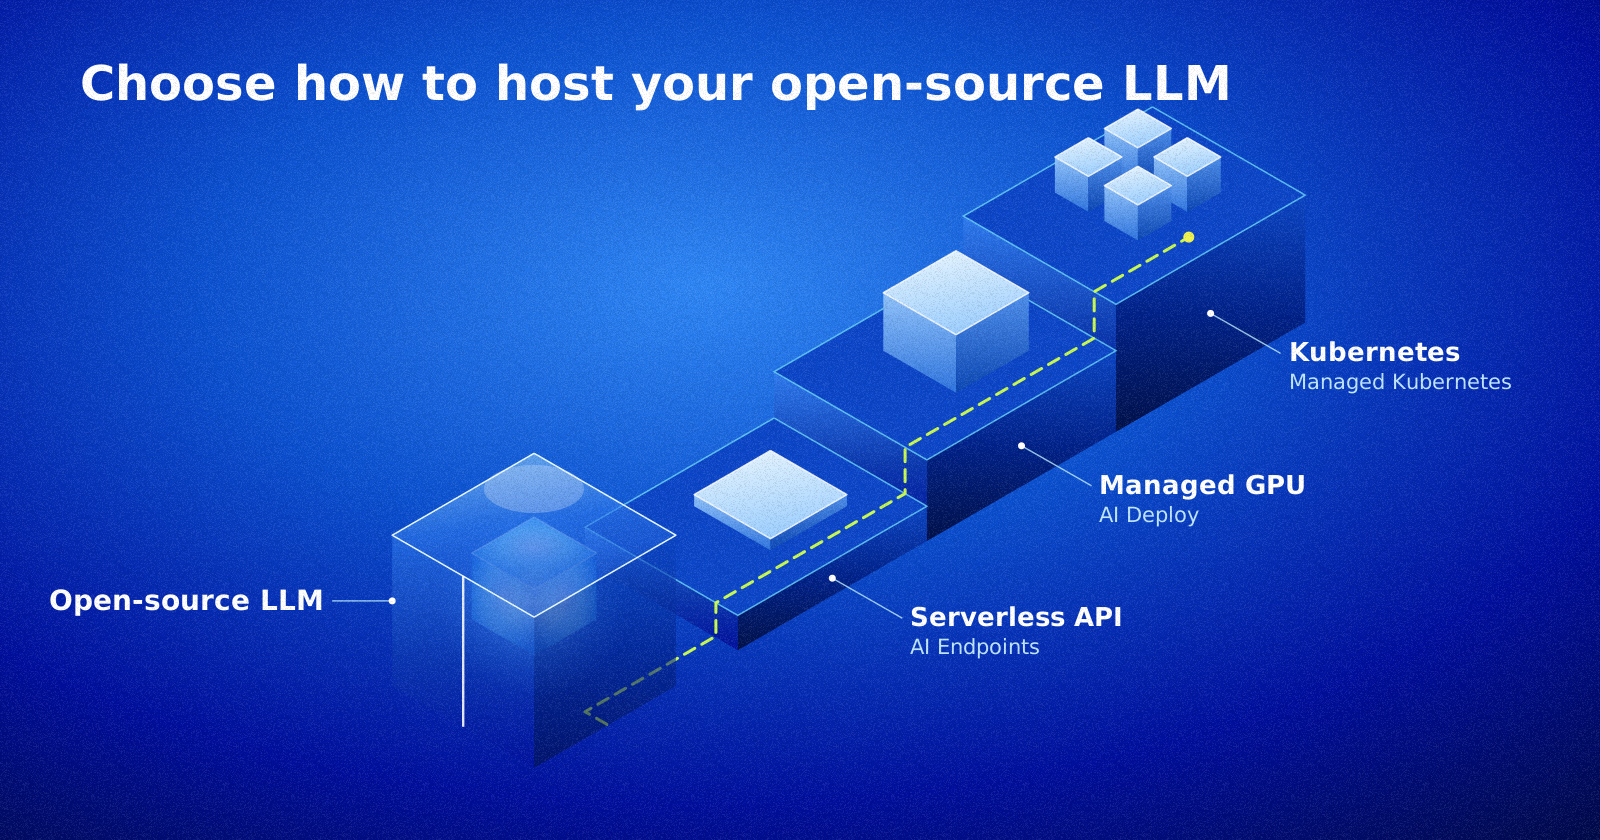
Escolheu o seu modelo open-weight. Metade do trabalho está feita. Resta, no entanto, uma decisão que pesará nos seus custos, na sua latência e no seu controlo dos dados: onde e como executá-lo. Para alojar um LLM, tem à sua disposição três grandes opções. Este guia compara-as e dá-lhe cinco critérios concretos para fazer a sua escolha.
Três formas de expor um modelo
As opções distinguem-se sobretudo pelo que gere por si próprio:
- inferência a pedido: aceda a modelos abertos por API, já otimizados para utilizações padrão;
- plataforma gerida de orquestração de contentores: um serviço de gestão de contentores como o Kubernetes permite-lhe ajustar os seus modelos à escala e fornecer API aos seus utilizadores em poucas horas;
- IA serverless: execute cargas de trabalho contentorizadas em GPU ou CPU sem configurar a infraestrutura, reduzindo simultaneamente as despesas desnecessárias com GPU.
Quanto mais desce nesta lista, mais controlo ganha e mais responsabilidades operacionais assume. Em termos absolutos, nenhuma opção é melhor do que outra: cada uma responde a um perfil de projeto.
A inferência a pedido para implementar rapidamente serviços inteligentes
Com AI Endpoints, acede a um catálogo de modelos open-weight através de uma simples chamada API. A interface é compatível com as API compatíveis da OpenAI: se o seu código já chama uma API deste tipo, mudar de fornecedor resume-se frequentemente a modificar um URL e uma chave.
Esta opção é adequada quando:
- prototipa ou lança um primeiro caso de utilização;
- incorpora funcionalidades inteligentes no seu produto digital;
- um modelo do catálogo responde à sua necessidade.
O seu limite é a contrapartida da sua simplicidade. Utiliza os modelos propostos, na sua configuração. Se melhorou um modelo sobre os seus dados ou se precisa de um modelo ausente do catálogo, terá de passar para a opção seguinte.
IA serverless para implementar os seus próprios modelos
AI Deploy é uma plataforma de contentores concebida para modelos de IA. Fornece uma imagem Docker, por exemplo a do servidor de inferência open source vLLM, escolhe a sua GPU ou CPU e a plataforma trata do resto.
Mantém assim a escolha do modelo, da sua versão e dos seus parâmetros de serviço. O tutorial dedicado à implementação do Mistral Small 24B mostra que um único comando é suficiente para lançar um modelo deste tamanho em duas GPU L40S.
Esta opção é adequada quando:
- dispõe de modelos treinados especificamente para as suas tarefas, sobre os seus dados;
- precisa de controlar o desempenho dos seus modelos, o seu isolamento e os seus dados;
- quer dispor da sua própria API sem ter de otimizar você mesmo a sua plataforma de inferência.
Para ir mais longe neste modelo de implementação, o guia Como implementar LLM com vLLM detalha cada etapa.
Plataforma de orquestração para as suas necessidades de ajuste à escala
Se a sua equipa já explora o Kubernetes, implementar os seus modelos no Managed Kubernetes Service permite-lhe tratá-los como qualquer outra carga de trabalho. Adiciona nós GPU ao seu cluster, implementa o vLLM e liga a sua monitorização existente.
É a opção que oferece mais flexibilidade: alta disponibilidade, ajuste preciso à escala, colocalização do modelo com as suas aplicações e os seus dados, mas também servidor API, gestão de direitos e acessos, isolamento de recursos. É também a que exige mais competências. Atualizar controladores de GPU ou ajustar o autoscaling é da responsabilidade da sua equipa.
Esta opção é adequada quando:
- dispõe de competências de gestão de plataformas de contentores, sendo o Kubernetes a mais conhecida;
- precisa de grandes capacidades, de desempenho estável, de gestão de recursos e de um isolamento completo;
- pretende uma arquitetura única para as suas aplicações e os seus modelos.
Alojamento de um LLM: cinco critérios para decidir
Para escolher, coloque a si próprio estas cinco perguntas por ordem.
1. O seu consumo de tokens é irregular? Adiciona inteligência às suas aplicações sem ainda poder estimar a sua pegada, precisa de vários fornecedores de modelos a pedido ou especializa os seus agentes por tarefa: a faturação por utilização da inferência a pedido é, então, adequada. Um consumo sustentado e previsível pode tornar os recursos dedicados mais interessantes.
2. Que latência pretende atingir? A latência tem um impacto direto na experiência dos seus utilizadores. Se precisa de tempos de resposta estáveis em muitos pedidos simultâneos, os recursos dedicados são preferíveis.
3. O seu modelo é padrão? Se os seus casos de utilização não necessitam de um modelo treinado nos seus conjuntos de dados, os modelos prontos a usar podem ser competitivos.
4. De que competências internas dispõe? Configurar e manter a sua própria plataforma de inferência pode revelar-se complexo, mesmo com competências em ciência de dados. Se optar por esta solução por razões contratuais ou setoriais, contacte especialistas da área.
5. Qual é o seu modelo económico? A maioria dos serviços a pedido paga-se por utilização, por unidade consumida. Se as suas utilizações permanecerem limitadas, o tempo ganho na colocação em produção de uma plataforma e na sua manutenção pode fazer pender a balança para uma solução totalmente gerida por um fornecedor.
Critério
Inferência a pedido
IA serverless
Plataforma de orquestração
Ativação
Imediata
Rápida
Mais longa
Escolha do modelo
Catálogo
Flexível
Flexível
Exploração
Nenhuma
Baixa
Grande
Consumo de tokens
Irregular
Regular
Sustentado, multimodelos
Competências necessárias
Baixas
Médias
Grandes
O AI Endpoints é operado a partir do datacenter de Gravelines, em França, numa infraestrutura sujeita ao direito europeu. Para a IA serverless e a plataforma de orquestração, a localização dos seus dados depende da região que escolher durante a implementação: selecione uma região europeia se os seus dados tiverem de permanecer na Europa.
Do laboratório à produção, evolua através das nossas diferentes stacks
Muitos projetos seguem a mesma trajetória. Começam com inferência a pedido para validar a utilização, passam por recursos de IA serverless quando o modelo se especializa e, depois, ajustam à escala numa plataforma de orquestração do tipo Kubernetes quando a IA se torna um componente central da arquitetura de aplicações.
Nos três casos, os seus contratos de API permanecem os mesmos: a API compatível com OpenAI é utilizada nos nossos serviços geridos AI Endpoints e AI Deploy (por exemplo, com vLLM). Assim, não precisa de reescrever as suas rotas de API a cada aumento de potência e mantém a configuração da sua cadeia agêntica, mantendo os mesmos modelos open-weight.
Para alojar um LLM já hoje sem incorrer em custos de infraestrutura significativos, comece por testar o AI Endpoints no seu caso de utilização e, depois, faça evoluir a sua arquitetura ao ritmo do seu tráfego.