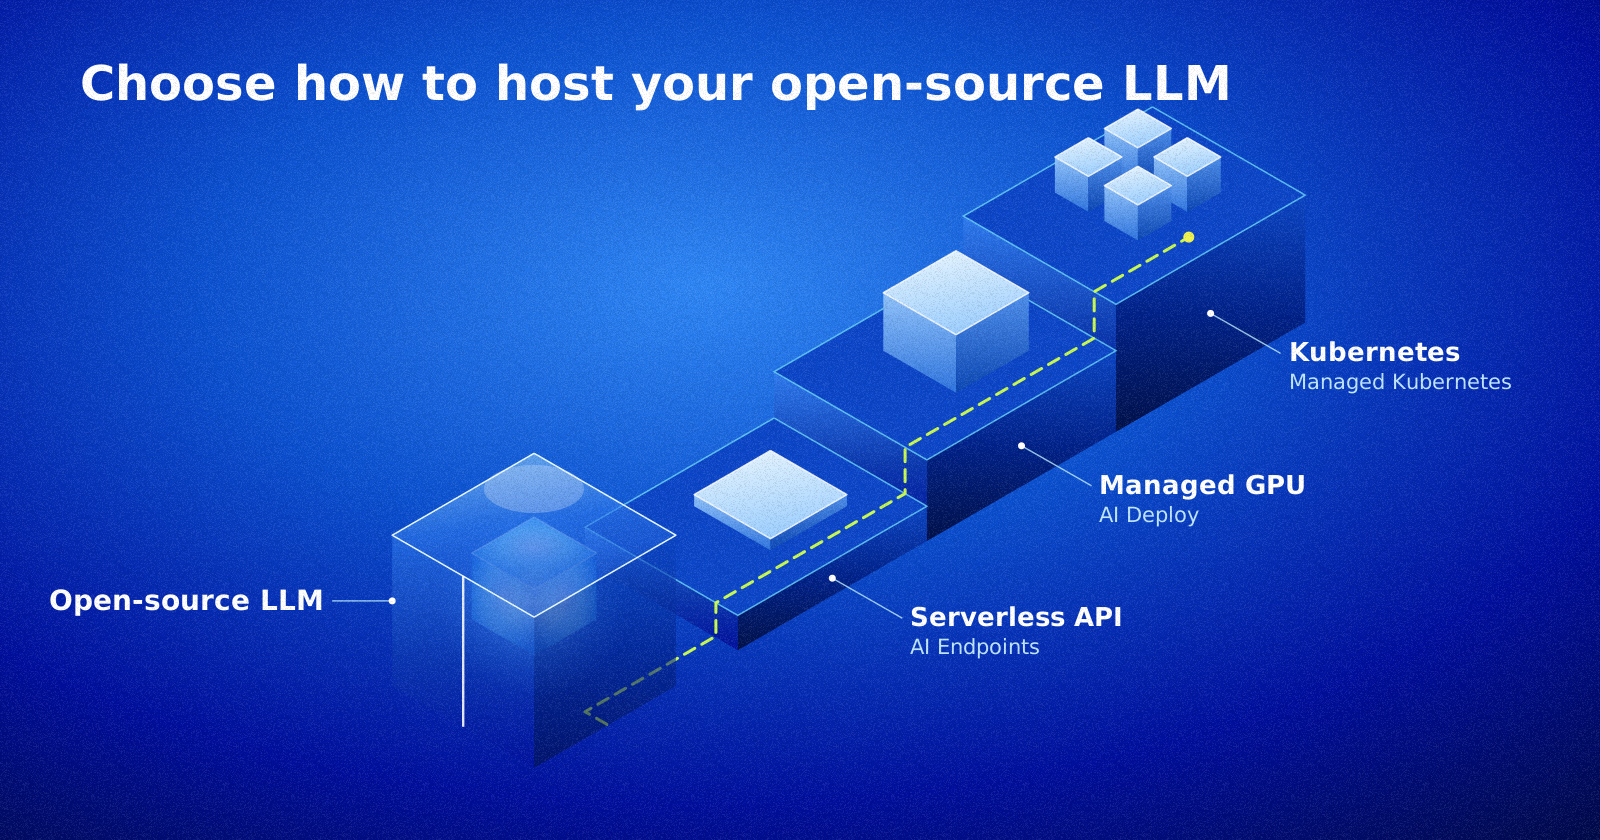
U heeft uw open-weight model gekozen. De helft van het werk is al gedaan. U dient echter nog één beslissing te nemen die van invloed zal zijn op de kosten, de latentie en het gegevensbeheer: waar en hoe u het laat draaien. Om een LLM te hosten, zijn er drie belangrijke opties waaruit u kunt kiezen. Deze gids vergelijkt ze en geeft u vijf concrete criteria om uw keuze te kunnen maken.
Drie manieren om een model aan te bieden
De opties onderscheiden zich vooral door wat u zelf beheert:
- inferentie op aanvraag: krijg toegang tot open modellen via API, die al geoptimaliseerd zijn voor standaardgebruik;
- managed container orchestration platform: een containerbeheerdienst zoals Kubernetes stelt u in staat uw modellen op te schalen en binnen enkele uren API's aan uw gebruikers te leveren;
- serverless AI: voer gecontaineriseerde workloads uit op GPU of CPU zonder de infrastructuur te configureren, terwijl u onnodige GPU-uitgaven vermindert.
Hoe verder u in deze lijst naar beneden gaat, hoe meer controle u krijgt en hoe meer operationele verantwoordelijkheden u op u neemt. In absolute zin is geen enkele optie beter dan de andere: elke optie voldoet aan een projectprofiel.
Inferentie op aanvraag om snel intelligente diensten te implementeren
Met AI Endpoints krijgt u toegang tot een catalogus van open-weight modellen via een eenvoudige API-aanroep. De interface is compatibel met OpenAI-compatibele API's: als uw code al een dergelijke API aanroept, komt het veranderen van provider vaak neer op het wijzigen van een URL en een sleutel.
Deze optie is geschikt wanneer:
- u aan het prototypen bent of een eerste use case lanceert;
- u intelligente functionaliteiten in uw digitale product integreert;
- een model uit de catalogus aan uw behoefte voldoet.
De beperking ervan is de keerzijde van de eenvoud. U gebruikt de aangeboden modellen in hun configuratie. Als u een model op uw gegevens hebt afgestemd of als u een model nodig hebt dat niet in de catalogus staat, zult u moeten overstappen op de volgende optie.
Serverless AI voor het implementeren van uw eigen modellen
AI Deploy is een containerplatform dat is ontworpen voor AI-modellen. U levert een Docker-image, bijvoorbeeld die van de open-source vLLM-inferentieserver, u kiest uw GPU of CPU en het platform zorgt voor de rest.
Zo behoudt u de modelkeuze, de versie ervan en de serviceparameters. De tutorial over het implementeren van Mistral Small 24B laat zien dat één enkel commando volstaat om een model van deze omvang op twee L40S GPU's te draaien.
Deze optie is geschikt wanneer:
- u beschikt over modellen die specifiek zijn getraind voor uw taken, op uw gegevens;
- u moet de prestaties van uw modellen, hun afscherming en uw gegevens beheersen;
- u wilt over uw eigen API beschikken zonder zelf uw inferentieplatform te hoeven optimaliseren.
Voor meer informatie over dit implementatiemodel beschrijft de gids Hoe LLM's implementeren met vLLM elke stap.
Orkestratieplatform voor uw schaalbehoeften
Als uw team al met Kubernetes werkt, kunt uw modellen implementeren op Managed Kubernetes Service om ze zo te behandelen als elke andere workload. U voegt GPU-nodes toe aan uw cluster, u implementeert vLLM en u verbindt uw bestaande monitoring.
Dit is de optie die de meeste flexibiliteit biedt: high availability, fijnmazige schaalbaarheid, co-lokalisatie van het model met uw applicaties en gegevens, maar ook een API-server, beheer van rechten en toegang, en isolatie van resources. Het is ook de optie die de meeste vaardigheden vereist. Het bijwerken van GPU-drivers of het aanpassen van autoscaling is de verantwoordelijkheid van uw team.
Deze optie is geschikt wanneer:
- u beschikt over vaardigheden in het beheer van containerplatforms, waarbij Kubernetes de bekendste is;
- u heeft behoefte aan aanzienlijke capaciteiten, stabiele performance, resourcebeheer en volledige afscherming;
- u wilt een unieke architectuur voor uw applicaties en uw modellen.
Een LLM hosten: vijf criteria om te beslissen
Stel uzelf deze vijf vragen, in deze volgorde, om een keuze te kunnen maken.
1. Is uw tokenverbruik onregelmatig? U voegt intelligentie toe aan uw applicaties zonder dat u hun voetafdruk al kunt inschatten, u heeft behoefte aan meerdere modelleveranciers op aanvraag of u specialiseert uw agents per taak: facturering op basis van gebruik voor inferentie op aanvraag is dan geschikt. Een constant en voorspelbaar verbruik kan toegewezen resources interessanter maken.
2. Welke latentie streeft u na? De latentie heeft een directe impact op de ervaring van uw gebruikers. Als u stabiele responstijden nodig heeft bij veel gelijktijdige verzoeken, hebben toegewezen resources de voorkeur.
3. Is uw model standaard? Als uw use cases geen model vereisen dat is getraind op uw datasets, kunnen kant-en-klare modellen zeer competitief zijn.
4. Over welke interne vaardigheden beschikt u? Het configureren en onderhouden van uw eigen inferentieplatform kan complex blijken, zelfs met vaardigheden in data science. Als u voor deze oplossing kiest om contractuele of sectorale redenen, neem dan contact op met experts in uw branche.
5. Wat is uw bedrijfsmodel? De meeste diensten op aanvraag worden gefactureerd op basis van gebruik, per verbruikte eenheid. Als uw gebruik beperkt blijft, kan de tijd die wordt bespaard op het in productie nemen van een platform en het onderhoud ervan de doorslag geven voor een oplossing die volledig door een leverancier wordt beheerd.
Criterium
Inferentie op aanvraag
IA serverless
Orchestratieplatform
Opstarten
Onmiddellijk
Snelle
Langer
keuze van het model
Catalogus
Flexibel
Flexibel
Gebruik
Geen
Laag
Hoog
Tokenverbruik
Onregelmatig
Regelmatig
Intensief, multimodellen
Vaardigheden vereist
Laag
Middelgroot
Hoog
AI Endpoints wordt beheerd vanuit het datacenter in Gravelines, Frankrijk, op een infrastructuur die onderworpen is aan de Europese wetgeving. Voor serverless AI en het orchestratieplatform hangt de lokalisatie van uw gegevens af van de regio die u kiest tijdens de implementatie: selecteer een Europese regio als uw gegevens in Europa moeten blijven.
Van lab naar productie, schaal op via onze verschillende stacks
Veel projecten volgen hetzelfde traject. Ze beginnen met inferentie op aanvraag om het gebruik te valideren, stappen over op serverless AI-resources wanneer het model zich specialiseert, en schalen vervolgens op naar een orchestratieplatform van het type Kubernetes wanneer AI een centraal onderdeel wordt van de applicatiearchitectuur.
In alle drie de gevallen blijven uw API-contracten hetzelfde: de OpenAI-compatibele API wordt gebruikt op onze beheerde AI Endpoints- en AI Deploy-services (bijvoorbeeld met vLLM). U hoeft uw API-routes dus niet te herschrijven bij elke opschaling en u behoudt de configuratie van uw agentische keten door dezelfde open-weight modellen te blijven gebruiken.
Om vandaag nog een LLM te hosten zonder hoge infrastructuurkosten te maken, begint u met het testen van AI Endpoints voor uw use case en schaalt u vervolgens uw architectuur, afhankelijk van uw verkeer.