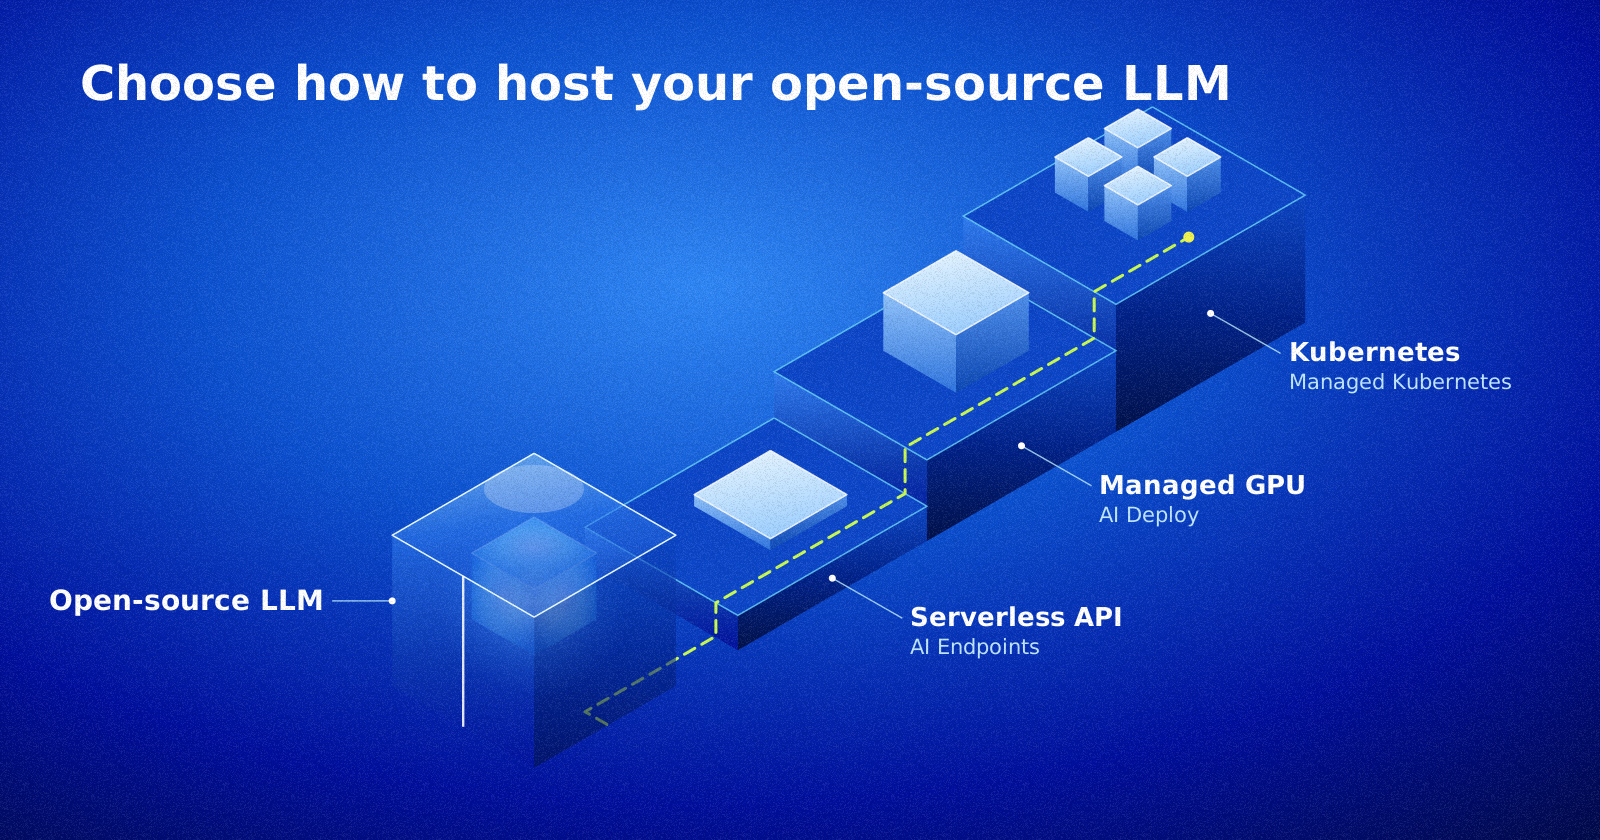
Hai scelto il tuo modello open-weight. Metà del lavoro è fatta. Rimane tuttavia una decisione che influirà sui costi, sulla latenza e sul controllo dei dati: dove e come farlo funzionare. Per ospitare un LLM, hai tre opzioni principali a disposizione. Questa guida le confronta e ti fornisce cinque criteri pratici per fare la scelta adatta a te.
Tre modi per esporre un modello
Le opzioni si distinguono soprattutto per ciò che viene gestito dall’utente stesso:
- inferenza on demand: accedi a modelli aperti tramite API, già ottimizzati per usi standard;
- piattaforma gestita per l’orchestrazione dei container: un servizio di gestione dei container come Kubernetes ti consente di scalare i tuoi modelli e di fornire API agli utenti in poche ore;
- IA serverless: esegui carichi di lavoro containerizzati su GPU o CPU senza configurare l’infrastruttura, riducendo al tempo stesso le spese superflue per le GPU.
Più scendi in questa lista, più acquisisci controllo e più assumi responsabilità operative. In assoluto, nessuna opzione è migliore di un’altra: ognuna risponde a un profilo di progetto.
L’inferenza on demand per il deployment rapido di servizi intelligenti
Con AI Endpoints puoi possibile accedere a un catalogo di modelli open-weight tramite una semplice chiamata API. L’interfaccia è compatibile con le API di OpenAI: se il tuo codice chiama già un’API di questo tipo, cambiare fornitore spesso implica semplicemente modificare un URL e una chiave.
Questa opzione è indicata se:
- stai realizzando un prototipo o lanciando un primo caso d’uso;
- integri funzionalità intelligenti nel tuo prodotto digitale;
- un modello del catalogo soddisfa le tue esigenze.
È proprio la sua semplicità a costituirne il limite. Utilizzi i modelli proposti, nella loro configurazione. Se hai perfezionato un modello sulla base dei tuoi dati o se hai bisogno di un modello che non è presente nel catalogo, dovrai passare all’opzione successiva.
IA serverless per implementare i tuoi modelli
AI Deploy è una piattaforma di container concepita per i modelli di IA. Basta fornire un’immagine Docker, ad esempio quella del server di inferenza open source vLLM, scegliere la GPU o la CPU e la piattaforma si occuperà del resto.
In questo modo, puoi scegliere il modello, la versione e i parametri di servizio. Il tutorial dedicato al deployment di Mistral Small 24B mostra che basta un solo comando per eseguire un modello di queste dimensioni su due GPU L40S.
Questa opzione è indicata se:
- hai modelli addestrati specificamente per i tuoi compiti, sui tuoi dati;
- devi avere il pieno controllo delle prestazioni dei tuoi modelli, del loro isolamento e dei tuoi dati;
- vuoi disporre della tua API senza dover ottimizzare la tua piattaforma di inferenza.
Per saperne di più su questo modello di deploy, la guida Come eseguire il deploy di LLM con vLLM descrive ogni passo.
Piattaforma di orchestrazione per le tue esigenze di scalabilità
Se il tuo team utilizza già Kubernetes, eseguire il deploy dei tuoi modelli su Managed Kubernetes Service ti consente di gestirli come qualsiasi altro carico di lavoro. Aggiungi i nodi GPU al tuo cluster, implementa vLLM e collega il tuo sistema di monitoraggio esistente.
È l’opzione che offre la massima flessibilità: alta disponibilità, scalabilità granulare, collocazione del modello insieme alle tue applicazioni e ai tuoi dati, ma anche server API, gestione dei diritti e degli accessi, isolamento delle risorse. È anche quella che richiede più competenze. L’aggiornamento dei driver della GPU o la regolazione dell’autoscaling sono responsabilità del tuo team.
Questa opzione è indicata se:
- hai esperienza nella gestione di piattaforme di container considerato che Kubernetes è la più conosciuta;
- hai bisogno di capacità elevate, prestazioni stabili, gestione delle risorse e isolamento completo;
- vuoi un’architettura unica per le tue applicazioni e i tuoi modelli.
Hosting di un LLM: cinque criteri per decidere
Per scegliere, poniti queste cinque domande nell’ordine.
1. Il tuo consumo di token è irregolare? Se aggiungi funzionalità intelligenti alle tue applicazioni senza poter ancora stimarne l’impatto, se hai bisogno di più fornitori di modelli on demand o se specializzi i tuoi agenti in base alle attività, la fatturazione a consumo per l’inferenza on demand è la soluzione più adatta. Un consumo sostenuto e prevedibile può rendere più interessanti le risorse dedicate.
2. Qual è la latenza che vuoi raggiungere? La latenza ha un impatto diretto sull’esperienza degli utenti. Se hai bisogno di tempi di risposta stabili su molte richieste simultanee, le risorse dedicate sono preferibili.
3. Il tuo modello è standard? Se i tuoi casi d’uso non richiedono un modello addestrato sui tuoi dataset, i modelli pronti all’uso possono rivelarsi assolutamente competitivi.
4. Quali sono le tue competenze interne? Configurare e mantenere la propria piattaforma di inferenza può essere complesso, anche per chi ha competenze in data science. Se opti per questa soluzione per ragioni contrattuali o settoriali, contatta gli esperti di settore.
5. Qual è il tuo modello economico? La maggior parte dei servizi on demand viene addebitata in base all’utilizzo, per unità di consumo. Se il tuo utilizzo rimane limitato, il tempo risparmiato nella messa in produzione di una piattaforma e nella sua manutenzione può far pendere l’ago della bilancia verso una soluzione interamente gestita da un fornitore.
Criterio
Inferenza on demand
IA serverless
Piattaforma di orchestrazione
Attivazione
Immediata
Rapida
Più lunga
Scelta del modello
Catalogo
Flessibile
Flessibile
Utilizzo
Nessuno
Basso
Importante
Consumo di token
Irregolare
Periodico
Sostenuto, multi-modelli
Competenze richieste
Basse
Medie
Importanti
AI Endpoints è gestito dal datacenter di Gravelines, in Francia, su un’infrastruttura soggetta alla normativa europea. Per l’IA serverless e la piattaforma di orchestrazione, la localizzazione dei dati dipende dalla regione che scegli durante il deployment: seleziona una regione europea se i tuoi dati devono rimanere in Europa.
Dal laboratorio alla produzione, evolvi attraverso i nostri diversi stack
Molti progetti seguono la stessa traiettoria. Iniziano con l’inferenza on demand per convalidare l’utilizzo, passano a risorse di IA serverless quando il modello si specializza, per poi scalare su una piattaforma di orchestrazione di tipo Kubernetes quando l’IA diventa un elemento centrale dell’architettura applicativa
In tutti e tre i casi, i tuoi contratti API rimangono gli stessi: l’API compatibile con OpenAI viene utilizzata sui nostri servizi AI Endpoints e AI Deploy gestiti (ad esempio con vLLM). Non è quindi necessario riscrivere i percorsi API ad ogni aumento di potenza e si mantengono le impostazioni della catena di agenti utilizzando gli stessi modelli open-weight.
Per ospitare un LLM oggi senza incorrere in costi di infrastruttura elevati, inizia provando AI Endpoints sul tuo caso d’uso e poi scala l’architettura in base al tuo traffico.