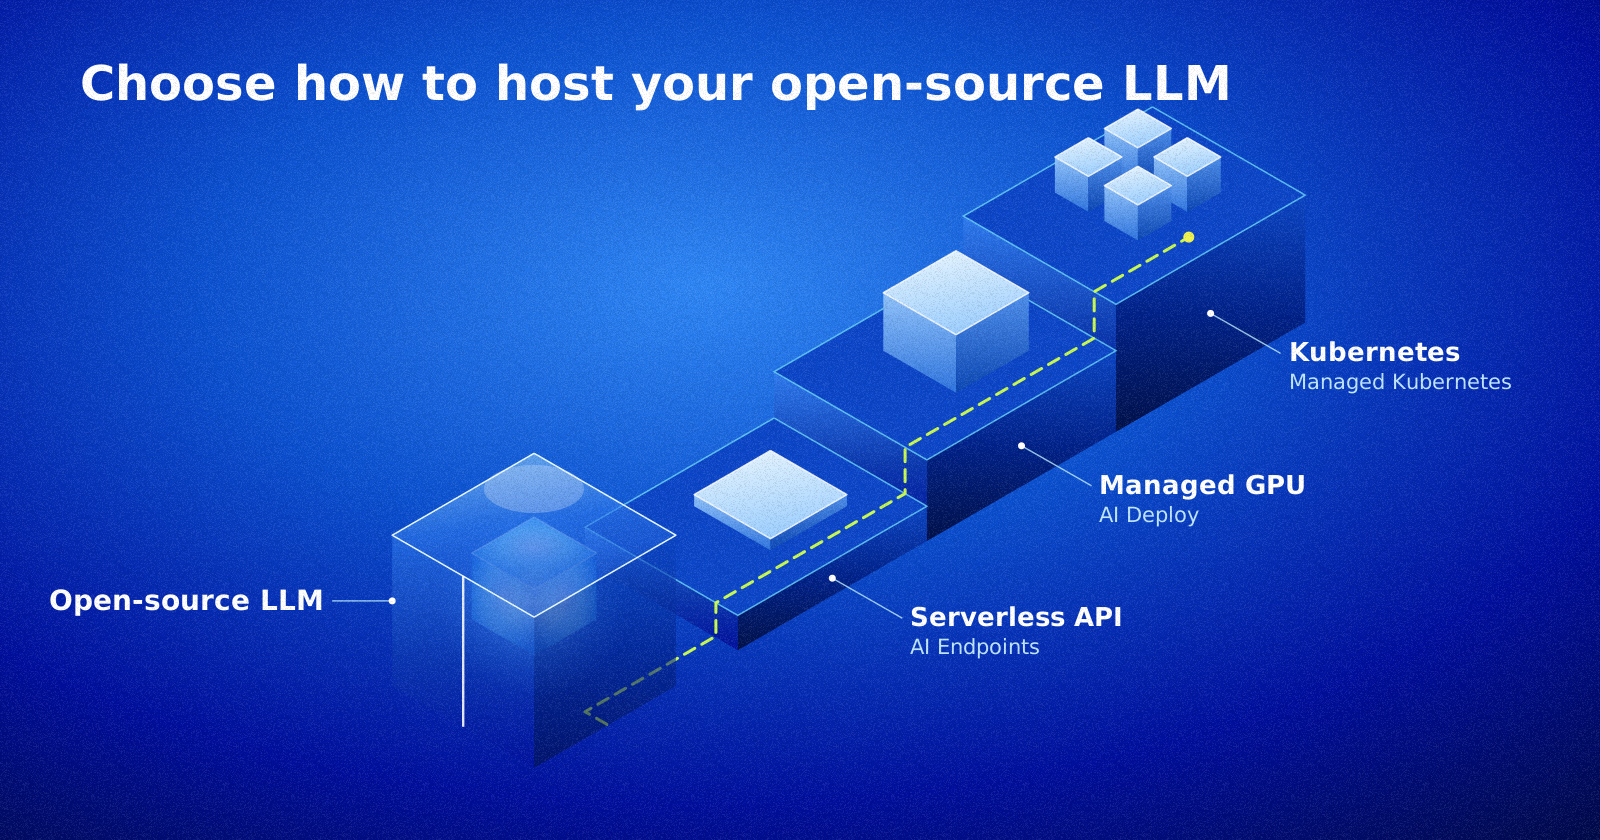
Vous avez choisi votre modèle open-weight. La moitié du travail est faite. Il reste néanmoins une décision qui pèsera sur vos coûts, votre latence et votre contrôle des données : où et comment le faire tourner. Pour héberger un LLM, trois grandes options s’offrent à vous. Ce guide les compare et vous donne cinq critères concrets pour faire votre choix.
Trois façons d’exposer un modèle
Les options se distinguent surtout par ce que vous gérez vous-même :
- inférence à la demande : accédez à des modèles ouverts par API, déjà optimisés pour des usages standards ;
- plateforme managée d’orchestration de conteneurs : un service de gestion de conteneurs comme Kubernetes vous permet de mettre vos modèles à l’échelle et de fournir en quelques heures des API à vos utilisateurs et utilisatrices ;
- IA serverless : exécutez des charges de travail conteneurisées sur GPU ou CPU sans configurer l’infrastructure, tout en réduisant les dépenses GPU inutiles.
Plus vous descendez dans cette liste, plus vous gagnez en contrôle et plus vous prenez de responsabilités opérationnelles. Dans l’absolu, aucune option n’est meilleure qu’une autre : chacune répond à un profil de projet.
L’inférence à la demande pour déployer rapidement des services intelligents
Avec AI Endpoints, vous accédez à un catalogue de modèles open-weight par simple appel API. L’interface est compatible avec les API compatibles d’OpenAI : si votre code appelle déjà une API de ce type, changer de fournisseur revient souvent à modifier une URL et une clé.
Cette option convient quand :
- vous prototypez ou lancez un premier cas d’usage ;
- vous embarquez des fonctionnalités intelligentes dans votre produit numérique ;
- un modèle du catalogue répond à votre besoin.
Sa limite est la contrepartie de sa simplicité. Vous utilisez les modèles proposés, dans leur configuration. Si vous avez affiné un modèle sur vos données ou si vous avez besoin d’un modèle absent du catalogue, vous devrez passer à l’option suivante.
IA serverless pour déployer vos propres modèles
AI Deploy est une plateforme de conteneurs pensée pour les modèles d’IA. Vous fournissez une image Docker, par exemple celle du serveur d’inférence open source vLLM, vous choisissez votre GPU ou CPU et la plateforme se charge du reste.
Vous gardez ainsi le choix du modèle, de sa version et de ses paramètres de service. Le tutoriel consacré au déploiement de Mistral Small 24B montre qu’une seule commande suffit pour lancer un modèle de cette taille sur deux GPU L40S.
Cette option convient quand :
- vous disposez de modèles entraînés spécifiquement pour vos tâches, sur vos données ;
- vous avez besoin de maîtriser la performance de vos modèles, leur isolation et vos données ;
- vous voulez disposer de votre propre API sans avoir à optimiser vous-même votre plateforme d’inférence.
Pour aller plus loin sur ce modèle de déploiement, le guide Comment déployer des LLM avec vLLM détaille chaque étape.
Plateforme d’orchestration pour vos besoins de mise à l’échelle
Si votre équipe exploite déjà Kubernetes, déployer vos modèles sur Managed Kubernetes Service vous permet de les traiter comme n’importe quelle autre charge de travail. Vous ajoutez des nœuds GPU à votre cluster, vous déployez vLLM et vous connectez votre supervision existante.
C’est l’option qui offre le plus de flexibilité : haute disponibilité, mise à l’échelle fine, colocalisation du modèle avec vos applications et vos données, mais aussi serveur API, gestion des droits et des accès, isolation des ressources. C’est également celle qui demande le plus de compétences. Mettre à jour des pilotes GPU ou ajuster l’autoscaling incombe à votre équipe.
Cette option convient quand :
- vous disposez de compétences en gestion de plateformes de conteneurs, Kubernetes étant la plus connue ;
- vous avez besoin de capacités importantes, de performances stables, de gestion des ressources et d’une isolation complète ;
- vous voulez une architecture unique pour vos applications et vos modèles.
Héberger un LLM : cinq critères pour trancher
Pour choisir, posez-vous ces cinq questions dans l’ordre.
1. Votre consommation de tokens est-elle irrégulière ? Vous ajoutez de l’intelligence à vos applications sans pouvoir encore estimer leur empreinte, vous avez besoin de plusieurs fournisseurs de modèles à la demande ou vous spécialisez vos agents par tâche : la facturation à l’usage de l’inférence à la demande est alors adaptée. Une consommation soutenue et prévisible peut rendre des ressources dédiées plus intéressantes.
2. Quelle latence visez-vous ? La latence a un impact direct sur l’expérience de vos utilisateurs et utilisatrices. Si vous avez besoin de temps de réponse stables sur de nombreuses requêtes simultanées, des ressources dédiées sont préférables.
3. Votre modèle est-il standard ? Si vos cas d’usage ne nécessitent pas de modèle entraîné sur vos jeux de données, des modèles prêts à l’emploi peuvent être tout à fait compétitifs.
4. De quelles compétences internes disposez-vous ? Configurer et maintenir votre propre plateforme d’inférence peut s’avérer complexe, même avec des compétences en data science. Si vous optez pour cette solution pour des raisons contractuelles ou sectorielles, rapprochez-vous d’expertes et experts métier.
5. Quel est votre modèle économique ? La plupart des services à la demande se paient à l’usage, par unité consommée. Si vos usages restent limités, le temps gagné sur la mise en production d’une plateforme et sur sa maintenance peut faire pencher la balance vers une solution entièrement gérée par un fournisseur.
| Critère | Inférence à la demande | IA serverless | Plateforme d’orchestration |
| Mise en route | Immédiate | Rapide | Plus longue |
| Choix du modèle | Catalogue | Flexible | Flexible |
| Exploitation | Aucune | Faible | Importante |
| Consommation de tokens | Irrégulière | Régulière | Soutenue, multimodèles |
| Compétences requises | Faibles | Moyennes | Importantes |
AI Endpoints est opéré depuis le datacenter de Gravelines, en France, sur une infrastructure soumise au droit européen. Pour l’IA serverless et la plateforme d’orchestration, la localisation de vos données dépend de la région que vous choisissez lors du déploiement : sélectionnez une région européenne si vos données doivent rester en Europe.
Du lab à la production, évoluez au travers de nos différentes stacks
Beaucoup de projets suivent la même trajectoire. Ils démarrent sur de l’inférence à la demande pour valider l’usage, passent sur des ressources d’IA serverless quand le modèle se spécialise, puis se mettent à l’échelle sur une plateforme d’orchestration de type Kubernetes quand l’IA devient une brique centrale de l’architecture applicative.
Dans les trois cas, vos contrats d’API restent les mêmes : l’API compatible OpenAI est utilisée sur nos services managés AI Endpoints et AI Deploy (par exemple avec vLLM). Vous n’avez donc pas besoin de réécrire vos routes d’API à chaque montée en puissance et vous conservez le paramétrage de votre chaîne agentique en gardant les mêmes modèles open-weight.
Pour héberger un LLM dès aujourd’hui sans engager de coûts d’infrastructure importants, commencez par tester AI Endpoints sur votre cas d’usage, puis faites évoluer votre architecture au rythme de votre trafic.