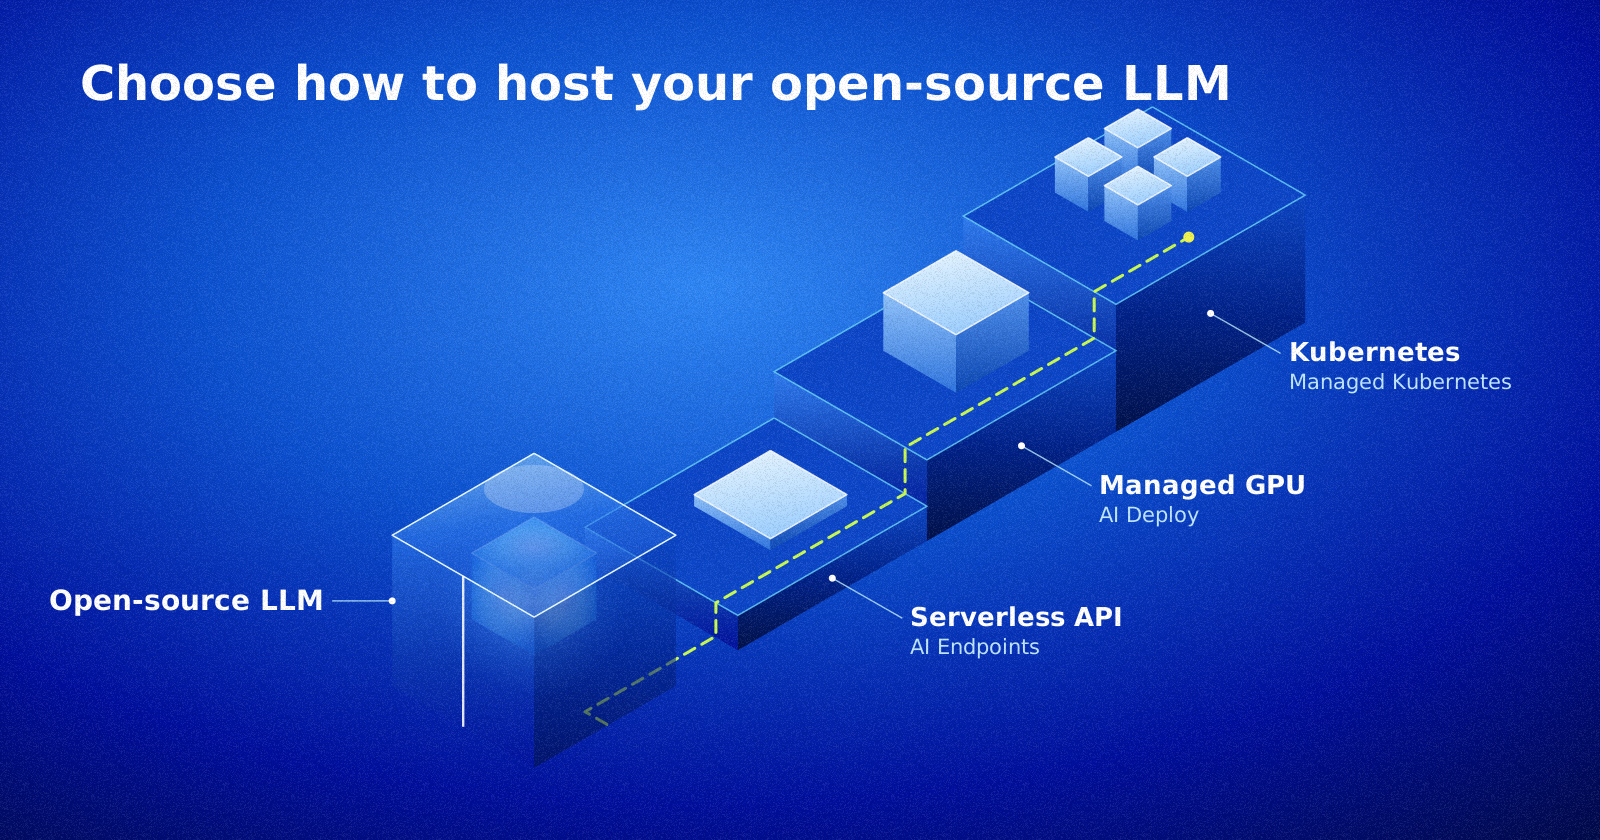
Ha seleccionado su modelo open-weight. La mitad del trabajo está hecha. Sin embargo, queda una decisión que afectará a los costes, la latencia y el control de los datos: dónde y cómo ejecutarlo. Para alojar un LLM, se le proponen tres grandes opciones. Esta guía las compara y le ofrece cinco criterios concretos para que haga su elección.
Tres formas de desplegar un modelo
Las opciones se diferencian principalmente por el hecho de que usted mismo las gestiona:
- inferencia bajo demanda: acceda a modelos abiertos a través de API, ya optimizados para usos estándar;
- plataforma gestionada de orquestación de contenedores: un servicio de gestión de contenedores como Kubernetes que le permite escalar sus modelos y ofrecer API a sus usuarios en cuestión de horas;
- IA serverless: ejecute cargas de trabajo en contenedores en GPU o CPU sin configurar la infraestructura, reduciendo al mismo tiempo los gastos innecesarios en GPU.
Cuanto más abajo esté en la lista, más control tendrá y más responsabilidades operativas asumirá. En principio, ninguna opción es mejor que otra: cada una responde a un perfil de proyecto.
Inferencia bajo demanda para desplegar rápidamente servicios inteligentes
Con AI Endpoints, puede acceder a un catálogo de modelos open-weight con una simple llamada API. La interfaz es compatible con las API compatibles de OpenAI: si su código ya llama a una API de este tipo, cambiar de proveedor suele implicar cambiar una URL y una clave.
Esta opción es adecuada cuando:
- está prototipando o lanzando un primer caso de uso;
- incorpora funcionalidades inteligentes a su producto digital;
- un modelo del catálogo responde a su necesidad.
Su límite es la contrapartida de su simplicidad. Utiliza los modelos propuestos, en su configuración. Si ha afinado un modelo en sus datos o necesita un modelo que no está en el catálogo, deberá pasar a la siguiente opción.
IA serverless para desplegar sus propios modelos
AI Deploy es una plataforma de contenedores diseñada para los modelos de IA. Usted proporciona una imagen Docker, por ejemplo, la del servidor de inferencia open source vLLM, selecciona su GPU o CPU y la plataforma se encargará del resto.
De esta forma, usted podrá elegir el modelo, la versión y los parámetros de servicio. El tutorial sobre el despliegue de Mistral Small 24B muestra que basta con un solo comando para ejecutar un modelo de este tamaño en dos GPU L40S.
Esta opción es adecuada cuando:
- dispone de modelos entrenados específicamente para sus tareas, con sus datos;
- necesita controlar el rendimiento de sus modelos, su aislamiento y sus datos;
- desea tener su propia API sin tener que optimizar su propia plataforma de inferencia.
Para profundizar en este modelo de despliegue, la guía Cómo desplegar LLM con vLLM detalla cada paso.
Plataforma de orquestación para sus necesidades de escalabilidad
Si su equipo ya está utilizando Kubernetes, el despliegue de sus modelos en Managed Kubernetes Service le permite tratar sus modelos como cualquier otra carga de trabajo. Usted añade nodos GPU a su clúster, despliega vLLM y conecta su supervisión existente.
Esta opción ofrece la mayor flexibilidad: alta disponibilidad, escalabilidad fina, coubicación del modelo junto a sus aplicaciones y datos, así como servidor API, gestión de derechos y accesos y aislamiento de recursos. También es la que requiere más competencias. La actualización de los drivers GPU o el ajuste del autoscaling es responsabilidad de su equipo.
Esta opción es adecuada cuando:
- tiene experiencia en la gestión de plataformas de contenedores, siendo Kubernetes la más conocida;
- necesita una capacidad importante, un rendimiento estable, la gestión de los recursos y un aislamiento completo;
- quiere una arquitectura única para sus aplicaciones y modelos.
Cinco criterios para decidir dónde alojar un LLM
Para elegir, hágase estas cinco preguntas en orden.
1. ¿Su consumo de tokens es irregular? Usted añade inteligencia a sus aplicaciones sin poder estimar aún su huella, necesita varios proveedores de modelos bajo demanda o especializa sus agentes por tarea: la facturación por uso de la inferencia bajo demanda es entonces adecuada. Un consumo elevado y predecible puede hacer que los recursos dedicados sean más interesantes.
2. ¿Á qué latencia aspira? La latencia tiene un impacto directo en la experiencia de sus usuarios y usuarias. Si necesita tiempos de respuesta estables para muchas solicitudes simultáneas, es mejor optar por recursos dedicados.
3. ¿Su modelo es estándar? Si sus casos de uso no requieren un modelo entrenado con sus conjuntos de datos, los modelos listos para usar pueden ser muy competitivos.
4. ¿Qué competencias internas tiene? Configurar y mantener su propia plataforma de inferencia puede resultar complejo, incluso con conocimientos en data science. Si opta por esta solución por motivos contractuales o sectoriales, póngase en contacto con expertos y expertas del sector.
5. ¿Cuál es su modelo de negocio? La mayoría de los servicios bajo demanda se pagan por uso, por unidad consumida. Si su uso es limitado, el tiempo ahorrado en la puesta en producción y el mantenimiento de una plataforma puede inclinar la balanza hacia una solución totalmente gestionada por un proveedor.
Criterio
Inferencia bajo demanda
IA serverless
Plataforma de orquestación
Activación
Inmediata
Rápida
Más larga
Selección del modelo
Catálogo
Flexible
Flexible
Gastos operativos
Ninguna
Bajo
Importante
Consumo de tokens
Irregular
Regular
Intensivo, multimodal
Competencias necesarias
Bajas
Medias
Importantes
AI Endpoints se opera desde el datacenter de Gravelines, en Francia, en una infraestructura sujeta al derecho europeo. Para el IA serverless y la plataforma de orquestación, la localización de sus datos depende de la región que elija durante el despliegue: seleccione una región europea si sus datos deben permanecer en Europa.
Desde el laboratorio hasta la producción, evolucione a través de nuestros diferentes stacks
Muchos proyectos siguen la misma trayectoria. Comienzan con la inferencia bajo demanda para validar el uso, pasan a recursos de IA serverless cuando el modelo se especializa y luego se escalan en una plataforma de orquestación de tipo Kubernetes cuando la IA se convierte en un componente central de la arquitectura de la aplicación.
En los tres casos, sus contratos de API siguen siendo los mismos: la API compatible con OpenAI se utiliza en nuestros servicios gestionados AI Endpoints y AI Deploy (por ejemplo, con vLLM). De esta forma, no tendrá que reescribir sus rutas de API en cada escalabilidad y podrá mantener la configuración de su cadena de agentes al conservar los mismos modelos open-weight.
Para alojar un LLM hoy mismo sin incurrir en grandes gastos de infraestructura, empiece por probar AI Endpoints en su caso de uso y luego escale su arquitectura a medida que aumenta el tráfico.