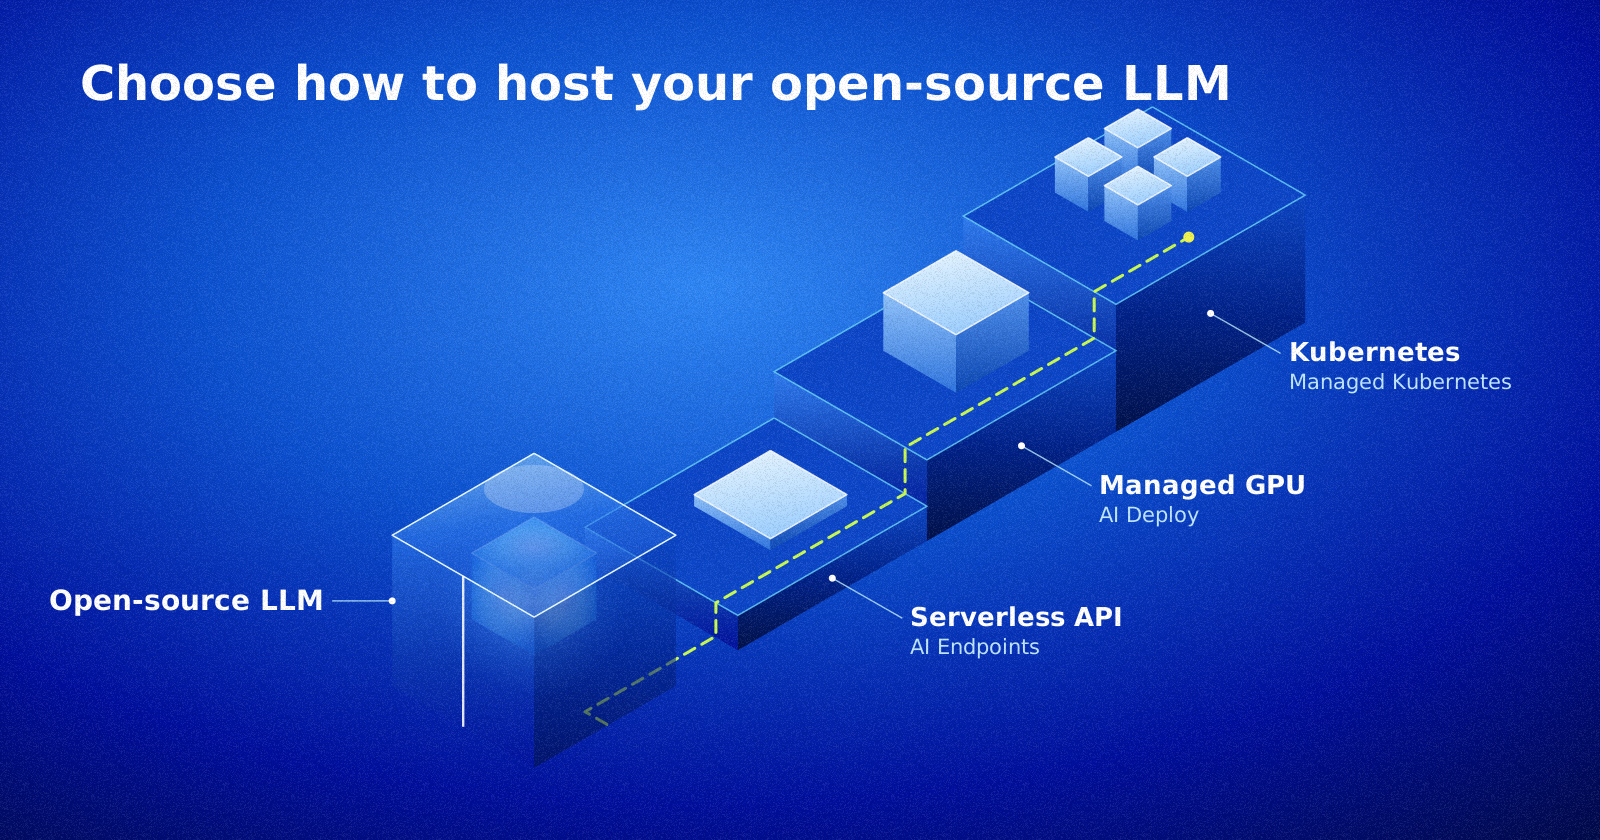
Sie haben sich für ein open-weight Modell entschieden. Die Hälfte der Arbeit ist erledigt. Es gibt jedoch noch eine Entscheidung, die sich auf Ihre Kosten, Latenz und Datenkontrolle auswirkt: Wo und wie Sie es betreiben. Für das Hosting eines LLM stehen Ihnen hauptsächlich drei Optionen zur Verfügung. Dieser Leitfaden vergleicht sie und gibt Ihnen fünf konkrete Kriterien, um Ihre Wahl zu treffen.
Drei Möglichkeiten, ein Modell zu veröffentlichen
Die Optionen unterscheiden sich vor allem durch das, was Sie selbst verwalten:
- On-Demand-Inferenz: Greifen Sie auf über APIs zugängliche Modelle zu, die bereits für Standardanwendungen optimiert sind;
- verwaltete Container-Orchestrierungsplattform: Ein Container-Management-Service wie Kubernetes ermöglicht es Ihnen, Ihre Modelle zu skalieren und innerhalb weniger Stunden APIs für Ihre Nutzer bereitzustellen.
- Serverless AI: Führen Sie containerisierte Workloads auf GPUs oder CPUs aus, ohne die Infrastruktur konfigurieren zu müssen, und reduzieren gleichzeitig unnötige GPU-Ausgaben.
Je weiter Sie in dieser Liste nach unten gehen, desto mehr Kontrolle und operative Verantwortung übernehmen Sie. Grundsätzlich ist keine Option besser als die anderen: Jede Option entspricht einem bestimmten Projektprofil.
On-Demand-Inferenz für die schnelle Bereitstellung intelligenter Dienste
Mit AI Endpoints greifen Sie über einen einfachen API-Aufruf auf einen Katalog von Open-Weight-Modellen zu. Die Schnittstelle ist mit den kompatiblen APIs von OpenAI vereinbar: Wenn Ihr Code bereits eine solche API aufruft, ist der Wechsel des Anbieters oft so einfach wie die Änderung einer URL und eines Schlüssels.
Diese Option ist geeignet, wenn:
- Sie einen ersten Use Case prototypen oder starten;
- Sie intelligente Funktionen in Ihr digitales Produkt einbinden;
- ein Modell aus dem Katalog Ihren Anforderungen entspricht.
Ihre Begrenztheit ist der Preis für ihre Einfachheit. Sie verwenden die vorgeschlagenen Modelle in deren Konfiguration. Wenn Sie ein Modell auf Ihren Daten verfeinert haben oder ein Modell benötigen, das nicht im Katalog vorhanden ist, müssen Sie zur nächsten Option wechseln.
Serverless AI, um Ihre eigenen Modelle bereitzustellen
AI Deploy ist eine Container-Plattform, die für AI-Modelle konzipiert wurde. Sie stellen ein Docker-Image bereit, z. B. dasjenige des Open-Source-Inferenzservers vLLM, wählen Ihre GPU oder CPU aus, und die Plattform kümmert sich um den Rest.
So behalten Sie die Wahl des Modells, der Version und der Service-Einstellungen. Das Tutorial zur Bereitstellung von Mistral Small 24B zeigt, dass ein einziger Befehl ausreicht, um ein Modell dieser Größe auf zwei L40S GPUs zu starten.
Diese Option ist geeignet, wenn:
- Sie über Modelle verfügen, die speziell für Ihre Aufgaben mit Ihren Daten trainiert wurden;
- Sie die Leistung Ihrer Modelle, deren Isolierung und Ihre Daten beherrschen müssen;
- Sie über Ihre eigene API verfügen möchten, ohne Ihre Inferenzplattform selbst optimieren zu müssen.
Um mehr über dieses Bereitstellungsmodell zu erfahren, beschreibt der Leitfaden Wie man LLMs mit vLLM bereitstellt jeden Schritt im Detail.
Orchestrierungsplattform für Ihren Skalierungsbedarf
Wenn Ihr Team bereits Kubernetes nutzt, können Sie Ihre Modelle auf Managed Kubernetes Service bereitstellen und wie jeden anderen Workload behandeln. Sie fügen GPU-Knoten zu Ihrem Cluster hinzu, implementieren vLLM und verbinden Ihre bestehende Überwachung.
Dies ist die Option mit der größten Flexibilität: hohe Verfügbarkeit, feingranulares Skalieren, Hosting des Modells in unmittelbarer Nähe zu Ihren Anwendungen und Daten, aber auch API-Server, Berechtigungs- und Zugriffsverwaltung, Ressourcenisolierung. Diese Option erfordert auch die meisten Kompetenzen. Die Aktualisierung der GPU-Treiber oder die Anpassung des Autoscalings ist Aufgabe Ihres Teams.
Diese Option ist geeignet, wenn:
- Sie Erfahrung in der Verwaltung von Container-Plattformen haben, wobei Kubernetes am bekanntesten ist;
- Sie hohe Kapazitäten, stabile Leistung, Ressourcenverwaltung und vollständige Isolierung benötigen;
- Sie eine einheitliche Architektur für Ihre Anwendungen und Modelle wollen.
Ein LLM hosten: fünf Kriterien zur Entscheidungsfindung
Um zu entscheiden, stellen Sie sich der Reihe nach diese fünf Fragen.
1. Ist Ihr Token-Verbrauch unregelmäßig? Sie fügen Intelligenz zu Ihren Anwendungen hinzu, noch ohne deren Auswirkung einschätzen zu können, Sie benötigen mehrere Anbieter von Modellen auf Abruf oder Sie spezialisieren Ihre Agenten nach Aufgaben: Dann ist die Abrechnung nach On-Demand-Inferenz sinnvoll. Eine nachhaltige und vorhersehbare Nutzung kann dedizierte Ressourcen attraktiver machen.
2. Welche Latenz streben Sie an? Die Latenz hat einen direkten Einfluss auf die Erfahrung Ihrer Nutzer. Wenn Sie stabile Antwortzeiten bei vielen gleichzeitigen Anfragen benötigen, sind dedizierte Ressourcen sinnvoller.
3. Ist Ihr Modell ein Standardmodell? Wenn Ihre Use Cases kein auf Ihren Datensätzen trainiertes Modell erfordern, können fertige Modelle durchaus wettbewerbsfähig sein.
4. Über welche internen Kompetenzen verfügen Sie? Die Einrichtung und Wartung einer eigenen Inferenzplattform kann selbst für Data-Science-Fachleute komplex sein. Wenn Sie aus vertraglichen oder branchenspezifischen Gründen diese Lösung wählen, wenden Sie sich bitte an unsere Experten und Branchenfachleute.
5. Wie sieht Ihr Geschäftsmodell aus? Die meisten On-Demand-Dienste werden nutzungsabhängig, pro verbrauchter Einheit, abgerechnet. Wenn Ihre Nutzung begrenzt bleibt, kann die Zeit, die Sie durch die Bereitstellung und Wartung einer Plattform sparen, dazu führen, dass eine vollständig vom Anbieter verwaltete Lösung den Zuschlag bekommt.
Kriterium
On-Demand-Inferenz
Serverless AI
Orchestrierungsplattform
Inbetriebnahme
Sofort
Schnell
Länger
Wahl des Modells
Katalog
Flexibel
Flexibel
Betrieb
Keine
Gering
Erheblich
Token-Verbrauch
Unregelmäßig
Regelmäßig
Unterstützt, Multimodelle
Erforderliche Kenntnisse
Gering
Durchschnittlich
Erheblich
AI Endpoints wird vom Rechenzentrum in Gravelines, Frankreich, aus betrieben und auf einer Infrastruktur, die dem europäischen Recht unterliegt. Für den serverlosen AI-Dienst und die Orchestrierungsplattform hängt die Datenlokalisierung von der Region ab, die Sie bei der Bereitstellung auswählen: Wählen Sie eine europäische Region, wenn Ihre Daten in Europa bleiben sollen.
Vom Labor bis zur Produktion wachsen Sie mit unseren verschiedenen Stacks
Viele Projekte folgen derselben Laufbahn. Sie beginnen mit der Inferenz auf Abruf, um die Nutzung zu validieren, wechseln zu serverless AI-Ressourcen, wenn das Modell spezialisiert ist, und skalieren dann auf einer Kubernetes-Orchestrierungsplattform, wenn AI zu einem zentralen Baustein der Anwendungsarchitektur wird.
In allen drei Fällen bleiben Ihre API-Verträge unverändert: Die OpenAI-kompatible API wird auf unseren verwalteten Diensten AI Endpoints und AI Deploy (z. B. mit vLLM) eingesetzt. Sie müssen also Ihre API-Routen nicht bei jedem Upgrade neu schreiben und können Ihre Agenten-Kettenkonfiguration beibehalten, indem Sie die gleichen Open-Weight-Modelle beibehalten.
Um heute ein LLM ohne hohe Infrastrukturkosten zu hosten, testen Sie zunächst AI Endpoints auf Ihren Use Case und skalieren dann Ihre Architektur entsprechend Ihrem Traffic.