Referentiearchitectuur: Langfuse implementeren op OVHcloud MKS voor LLM-observability en het monitoren van AI-kosten
Context
OVHcloud AI Endpoints biedt een OpenAI-compatibele API die applicaties toegang geeft tot een uitgebreide catalogus met open-weight modellen, waaronder Qwen, Llama, Mistral, gpt-oss, embedding, guard en spraakmodellen, zonder dat teams inferentie-infrastructuur hoeven te managen. Het is de op gebruik gebaseerde inferentielaag die door deze architectuur wordt gemonitord.
OVHcloud Managed Kubernetes Service (MKS) neemt de operationele last van het draaien van het Kubernetes-control plane weg: nodepools, upgrades en high availability worden afgehandeld door OVHcloud. Bovendien behoudt u de volledige controle over wat er op de workernodes draait. Het is de natuurlijke plek om een stateless applicatie zoals de web- en worker-processen van Langfuse te draaien, terwijl de stateful onderdelen (databases, Object Storage) zich in de gemanagede services van OVHcloud ernaast bevinden.
Langfuse levert de observability-laag voor applicaties die AI Endpoints gebruiken. Omdat de OpenAI SDK-integratie een drop-in vervanging is (van langfuse.openai import openai in plaats van import openai), is het verwijzen van een bestaande OpenAI-compatibele codebase naar AI Endpoints en het verkrijgen van volledige tracering een wijziging van twee regels, niet een hele rewrite.
Samen vormen deze drie onderdelen een self-hosted observability-stack die kosten toekent voor elke applicatie die AI Endpoints aanroept, zonder dat er ook maar één token aan prompt- of completion-data wordt verzonden buiten de infrastructuur die u beheert.
Langfuse op OVHcloud MKS voor LLM-observability en het bijhouden van tokengebruik
Architectuuroverzicht
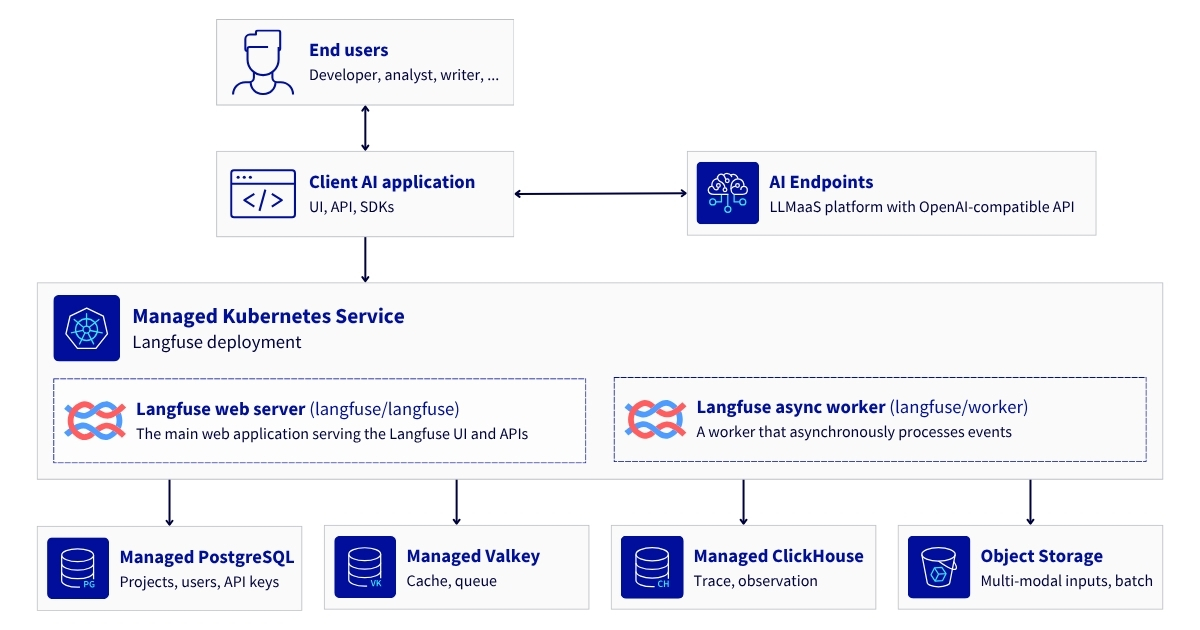
De web- en worker-implementaties van Langfuse draaien binnen het MKS-cluster. Ingress en certificaatbeheer draaien ernaast als afzonderlijke, herbruikbare cluster-add-ons. Elke stateful afhankelijkheid – Postgres, Valkey, ClickHouse, Object Storage – is een gemanagede OVHcloud-service buiten het cluster, benaderd via TLS.
1. Datastroom
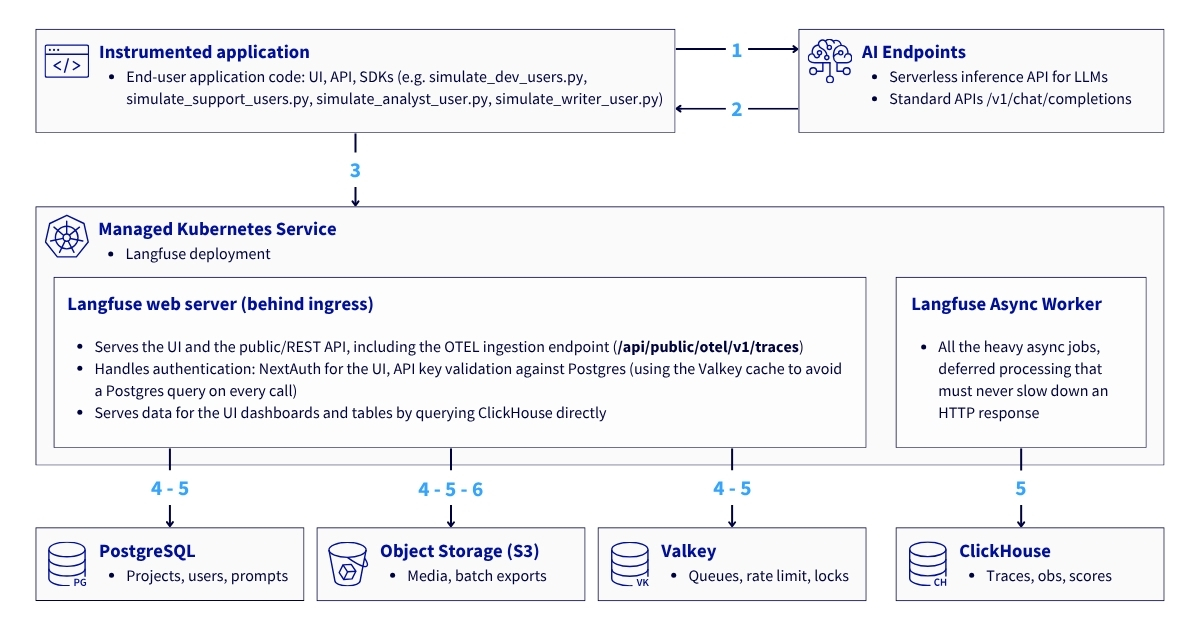
Alle onderdelen bij elkaar genomen verloopt een enkel getraceerd verzoek als volgt:
Datastroom
1. De applicatie roept AI Endpoints rechtstreeks aan
De drop-in openai.OpenAI() client stuurt het verzoek rechtstreeks naar de inferentie-API – Langfuse staat volledig buiten deze call, dus een Langfuse-storing beïnvloedt nooit of de applicatie een compleet antwoord kan krijgen.
2. AI Endpoints streamt het antwoord terug
De laatste chunk bevat de gegevens over het tokengebruik.
3. De SDK exporteert wat het zojuist heeft gezien als een OpenTelemetry span-batch
Dit gebeurt asynchroon, via HTTPS, naar /api/public/otel/v1/traces op de Langfuse-instance.
Dit proces draait op de achtergrond en voegt geen latency toe aan het antwoord dat de applicatie al heeft ontvangen in stap 2.
4. Langfuse web verwerkt de batch
Het controleert of de API-sleutel van het verzoek met het project in Postgres overeenkomt (de zoekactie wordt in Valkey gecachet, geen nieuwe query bij elke call), schrijft de onbewerkte batch onveranderd naar Object Storage en pusht alleen een verwijzing ernaar naar een Valkey-wachtrij.
5. De worker leegt die wachtrij volgens zijn eigen planning, losgekoppeld van alle verzoeken
Het haalt de verwijzing uit Valkey, haalt de volledige batch op uit Object Storage, lost het Prompt Management-item op waaraan deze is gekoppeld (indien van toepassing) via Postgres, en slaat de trace- en generatierecords op in ClickHouse (model, tokenaantallen, latency, prijzen)
6. De worker handelt ook alles af wat gepland of bulk is
Batch-exports en media-uploads komen in S3 terecht, onafhankelijk van wanneer het oorspronkelijke verzoek plaatsvond.
⚠️ Let op: Niets vanaf stap 3 kan latency toevoegen aan het applicatieverzoek in stappen 1-2; die asynchrone overdracht en het feit dat web nooit blokkeert op Postgres of ClickHouse om een batch te bevestigen, verklaren volledig waarom tracing niets kost op het kritieke pad.
2. AI Endpoints API's
Alles hieronder roept een van de twee afzonderlijke OVHcloud AI Endpoints API's aan:
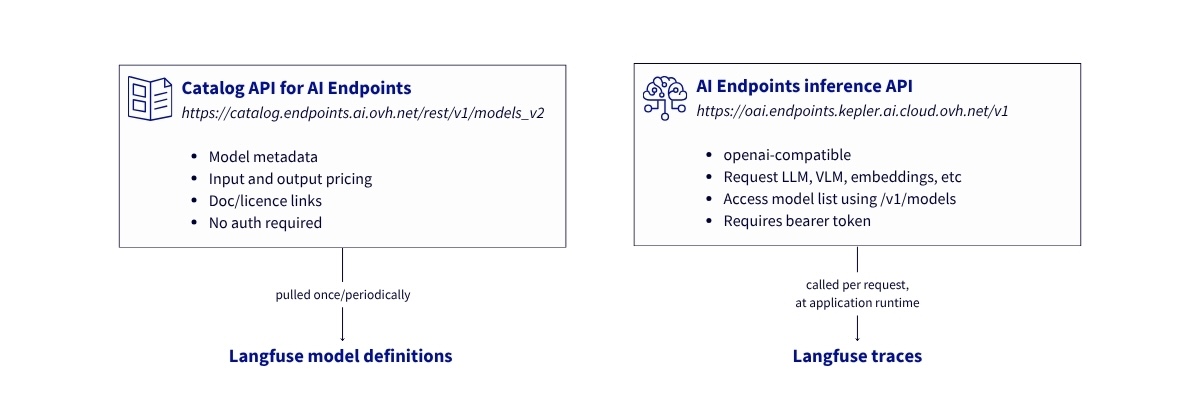
- Inferentie API: https://oai.endpoints.kepler.ai.cloud.ovh.net/v1
Dit is de API waarmee uw applicatie daadwerkelijk communiceert. Het implementeert het OpenAI API-oppervlak, dus elke OpenAI-compatibele SDK werkt ermee door de base_url en de API-sleutel te wijzigen:
import openai
client = openai.OpenAI(
     api_key="<your-ai-endpoints-token>",
     base_url="https://oai.endpoints.kepler.ai.cloud.ovh.net/v1",
 )

 response = client.chat.completions.create(
     model="Qwen3.5-397B-A17B",
     messages=[{"role": "user", "content": "hello"}],
 )
Als u het OpenAPI-schema rechtstreeks van de gateway ophaalt (GET /openapi.json), zult u zien dat de beschikbare interface veel verder gaat dan chatsuggesties.
Het is nuttig om de GET /v1/models API ten minste één keer rechtstreeks aan te roepen: deze retourneert alle modellen waartoe uw token toegang verleent.
De volgende sectie richt zich op de catalogus-API, waarmee u verdere informatie over de modellen kunt verkrijgen, inclusief details over prijzen, die nodig zijn voor het bijhouden van kosten.
- Catalogus API: https://catalog.endpoints.ai.ovh.net/rest/v1/models_v2
Dit is de API die de webcataloguspagina "AI Endpoints" aanstuurt. Het is een eenvoudig GET-verzoek waarvoor geen authenticatie vereist is. Het retourneert de volledige lijst met modellen, samen met de metadata die in de gebruikersinterface van de catalogus wordt weergegeven: beschrijving, benchmarkscores, producent, licentie, contextgrootte, links naar de playground en documentatie, evenals een usage_information.pricing blok:
curl -s https://catalog.endpoints.ai.ovh.net/rest/v1/models_v2 | jq '.[0]'Retourneert:
{
   "id": "qwen-3-5-397b",
   "name": "Qwen3.5-397B-A17B",
   "category": "Visual LLM",
   "metadata": {
     "aliases": ["Qwen/Qwen3.5-397B-A17B", "qwen3.5-397b-a17b"],
     "context": "262k",
     "usage_information": {
       "pricing": [
         {"price": 0.6, "price_unit": "million_input_tokens"},
         {"price": 3.6, "price_unit": "million_output_tokens"}
       ]
     }
   }
 }
De twee API's zijn complementair:
- de catalogus API is een eenmalige of periodieke pull die gebruikt wordt om lokale prijstabellen en metadata op te bouwen
- de inferentie API is wat een draaiende applicatie aanroept bij elk verzoek
De twee API's zijn complementair:
- de catalogus API is een eenmalige of periodieke pull die gebruikt wordt om lokale prijstabellen en metadata op te bouwen
- de inferentie API is wat een draaiende applicatie aanroept bij elk verzoek
AI Endpoints inferentie- en catalogus-API's
⚠️ Let op: Houd er rekening mee dat de prijzen van AI Endpoints in euro's zijn.
Vereisten
Zorg voordat u begint dat u beschikt over:
- Een OVHcloud Public Cloud-account
- Een OpenStack-gebruiker met de rol Administrator
- Een AI Endpoints API-sleutel
- Een domeinnaam die u naar een load balancer kunt laten wijzen
- kubectl geïnstalleerd en helm geïnstalleerd (ten minste versie 3.x)
Nu u alle ingrediënten heeft, is het tijd om Langfuse te implementeren met behulp van OVHcloud MKS en andere gemanagede services!
Architectuurgids: Implementatie van Langfuse op gemanagede services van OVHcloud Public Cloud
Stap 1 – Het Kubernetes-cluster en de OVHcloud managed services inrichten
De web- en worker-processen van Langfuse zijn zelf behoorlijk licht. De keuze voor bepaalde resources hangt daarom bijna volledig af van de gemanagede services waarmee ze omringd zijn. Hieronder staat een uitleg met de praktische stappen voor het instellen van elk daarvan.
Alles hieronder wordt aangemaakt in de OVHcloud Manager, onder het gedeelte Public Cloud van uw project.
1. MKS-cluster en Node-pools aanmaken
1.1. Cluster configureren
Maak vanuit het OVHcloud Control Panel een Kubernetes-cluster aan met behulp van MKS:
- Naam: langfuse-cluster
- Locatie: 1-AZ Regio – Gravelines (GRA11)
- Pakket: Gratis (of Standard)
- Netwerk: koppel een Privénetwerk (bijvoorbeeld 0000 - AI Privénetwerk)
- Versie: Recentste stabiele versie (bijvoorbeeld 1.35)
1.2. Node-pools aanmaken
Configureer tijdens het aanmaken van het cluster de 2 Node-pools.
De eerste is np-system. Deze voert componenten uit op clusterniveau, waaronder Traefik (ingress) en cert-manager (TLS-certificaten), evenals de standaard daemonsets van het Kubernetes-systeem.
- Naam van node-pool: np-system
- Flavor: B3-8
- Aantal nodes: 3
- Automatisch schalen: Uitgeschakeld (OFF)
De tweede is np-workload, alleen bedoeld voor de Langfuse-applicatiepods (web + worker).
- Naam van node-pool: np-workload
- Flavor: B3-16
- Aantal nodes: 1
- Automatisch schalen: Uitgeschakeld (OFF)
1.3. Kubernetes-toegang configureren
Zodra uw nodes zijn ingericht, kunt u het Kubeconfig-bestand downloaden en kubectl configureren met uw MKS-cluster.
# configure kubectl with your MKS cluster
 export KUBECONFIG=/path/to/your/kubeconfig-xxxxxx.yml

 # verify cluster connectivity
 kubectl cluster-info
 kubectl get nodes
Returns:
NAME STATUS ROLES AGE VERSION
 np-system-node-388e55 Ready <none> 12d v1.35.2
 np-system-node-4c5326 Ready <none> 12d v1.35.2
 np-system-node-93bc1c Ready <none> 12d v1.35.2
 np-workload-node-3a76f7 Ready <none> 12d v1.35.2
2. Databases configureren
2.1. Postgre-database voor transactionele Langfuse-gegevens
Klik in de sectie Databases van OVHcloud Public Cloud op Een service aanmaken en configureer deze als volgt:
- Engine: PostgreSQL
- Versie: 17
- Locatie: GRA
- Servicepakket: Business
- Instance: Db1-4
- Opslag: 80 GB (standaard)
- Netwerk: Publiek netwerk (internet)
Sla de volgende informatie veilig op voordat u doorgaat naar de volgende stap:
- host
- port
- databasenaam
- gebruikersnaam
- wachtwoord
- URI
2.2. Valkey-database voor jobcaching en wachtrijen
Klik in de sectie Databases van OVHcloud Public Cloud op Een service aanmaken en configureer deze als volgt:
- Engine: Valkey
- Versie: 8.1
- Locatie: GRA
- Servicepakket: Business
- Instance: Db1-4
- Opslag: 80 GB (standaard)
- Netwerk: Publiek netwerk (internet)
Sla de volgende informatie veilig op voordat u doorgaat naar de volgende stap:
- host
- port
- databasenaam
- gebruikersnaam
- wachtwoord
- URI
2.3. ClickHouse, het hart van observability-data
Klik vanuit de sectie Analytics in OVHcloud Public Cloud op Een service aanmaken en configureer deze als volgt:
- Engine: ClickHouse
- Versie: 25.8
- Locatie: EU-WEST-PAR
- Servicepakket: Production
- Instance: B3-16
- Opslag: 100 GB (standaard)
- Netwerk: Publiek netwerk (internet)
Sla de volgende informatie veilig op voordat u doorgaat naar de volgende stap:
- host
- port
- databasenaam
- gebruikersnaam
- wachtwoord
- URI
⚠ Let op: OVHcloud managed databases (Postgres, Valkey, ClickHouse) weigeren standaard alle verbindingen totdat u toegestane bron-IP's toevoegt op de pagina "IP-restricties" van elke instance in de OVHcloud Manager. Houd er rekening mee dat u de openbare IP's van uw MKS-nodepool moet toevoegen aan alle drie de databases voordat u Langfuse implementeert, anders zal elke verbinding vanuit het cluster simpelweg tot een time-out leiden.
Pas vanuit het tabblad Configuratie voor elke database de IP-whitelisting toe zoals weergegeven in het onderstaande voorbeeld:
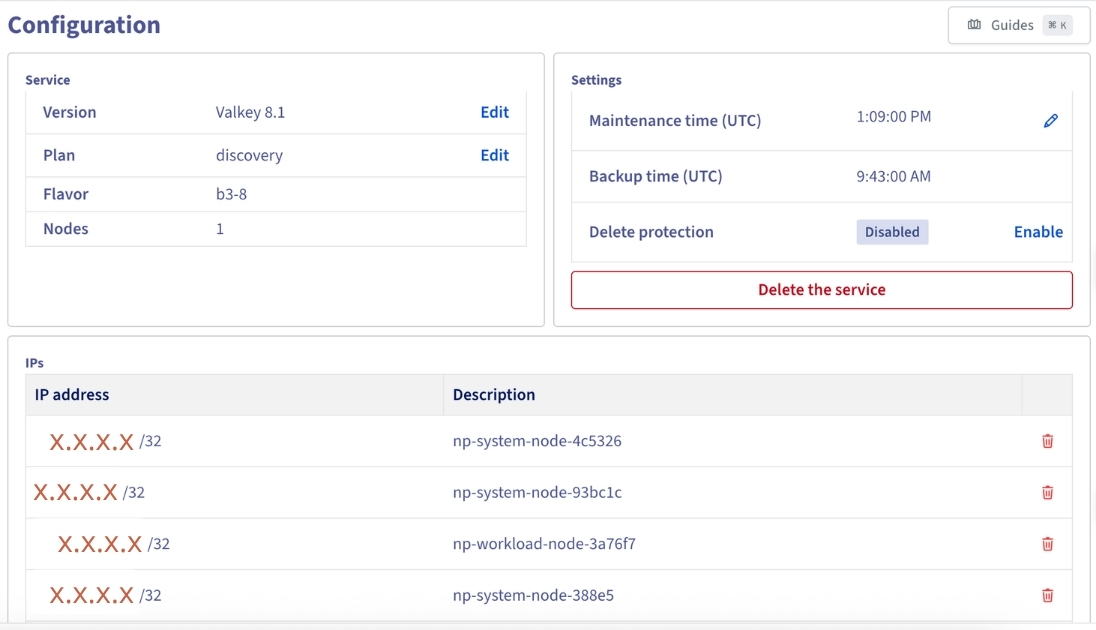
Whitelisting van de openbare IP's van de MKS-nodepool
3. Maak een S3-compatibele bucket aan als storage-backend
Maak vanuit de sectie Object Storage in OVHcloud Public Cloud een objectcontainer aan:
- Containertype: S3-compatibele API
- Locatie: GRA
Sla de volgende informatie veilig op voordat u doorgaat naar de volgende stap:
- bucketnaam
- eindpunt
- toegangssleutel
- geheime sleutel
Stap 2 – Bootstrap namespaces en quota
Maak eigen namespaces aan voor de ingress controller, certificate manager en Langfuse zelf, en beperk wat de Langfuse-namespace kan verbruiken, zodat een op hol geslagen workload de rest van het cluster niet plat kan leggen.
Maak eerst het volgende aan:
Start vervolgens de implementatie.
kubectl apply -f deploy/bootstrap/namespaces.yaml
kubectl apply -f deploy/bootstrap/resourcequota.yaml
Stap 3 – Installeer de ingress controller en certificate manager
Deze architectuur gebruikt Traefik in plaats van ingress-nginx.De volledige installatieopdrachten maken deel uit van
deploy/ingress/install.sh. U kunt het volgende uitvoeren:. You can run:
bash deploy/ingress/install.shhelm upgrade --install richt automatisch een nieuwe OVHcloud Load Balancer met een publiek IP-adres in. Wacht tot dit is toegewezen voordat u verdergaat:
kubectl -n traefik get svc traefik -wcert-manager regelt de uitgifte en vernieuwing van certificaten. Installeer het vanuit het OCI-register. Zowel OVHcloud als upstream bevelen dit beide nu aan in plaats van het verouderde Helm-repository.
Download het script cert-manager/install.sh en voer het uit:
bash cert-manager/install.shMaak vervolgens een ClusterIssuer aan voor Let's Encrypt, waarbij u Traefik gebruikt als de HTTP-01 “solver”.
Definieer eerst uw eigen e-mailadres in het bestand cert-manager/cluster-issuer.yaml.
⚠️ Let op: Let's Encrypt gebruikt dit voor meldingen over het verlopen van certificaten, en het cert-manager-register accepteert stilzwijgend een standaardwaarde als u vergeet er een op te geven. Deze stap moet wachten totdat cert-manager zelf actief is en de Traefik ingress-klasse aanwezig is, zodat de resolver ernaar kan verwijzen. Voer het daarom pas uit als de twee hierboven beschreven installaties zijn voltooid:
kubectl apply -f cert-manager/cluster-issuer.yaml⚠️ Let op: U moet de chart-versie expliciet vastzetten (--version). Anders zullen de twee bovenstaande commando's standaard de meest recente versie gebruiken die beschikbaar is op het moment van installatie, wat betekent dat de implementatie na verloop van tijd niet exact kan worden gereproduceerd.
Stap 4 – Configureer de DNS om naar de load balancer te wijzen
Zodra de Traefik-service een extern IP-adres heeft, maakt u een A-record aan voor de hostnaam waar Langfuse bereikbaar op is:
kubectl -n traefik get svc traefik -o jsonpath='{.status.loadBalancer.ingress[0].ip}'Maak langfuse.<uw-domein> aan -> het IP-adres in uw DNS-zone en bevestig dat het correct wordt opgezocht voordat u doorgaat – anders zal de HTTP-01 challenge van cert-manager stilletjes falen en alsmaar opnieuw blijven proberen.
Stap 5 – Sla inloggegevens op in een Kubernetes-secret en configureer de Helm-waarden
De Helm-chart van Langfuse leest elke inloggegeven vanuit een secret, niet vanuit platte tekst, zodat het values-bestand geen gevoelige gegevens hoeft te bevatten:
kubectl -n langfuse create secret generic langfuse-secrets \
   --from-literal=LANGFUSE_SALT="$(openssl rand -base64 32)" \
   --from-literal=LANGFUSE_SECRET_KEY="$(openssl rand -hex 32)" \
   --from-literal=NEXTAUTH_SECRET="$(openssl rand -base64 32)" \
   --from-literal=POSTGRES_PASSWORD="<your-postgres-password>" \
   --from-literal=VALKEY_PASSWORD="<your-valkey-password>" \
   --from-literal=CLICKHOUSE_PASSWORD="<your-clickhouse-password>" \
   --from-literal=S3_ACCESS_KEY="<your-s3-access-key>" \
   --from-literal=S3_SECRET_KEY="<your-s3-secret-key>"
De gebruikte chart is de officiële langfuse/langfuse-k8s chart. U kunt het volledige bestand vinden in de GitHub-repository public-cloud-examples van OVHcloud: deploy/langfuse/values.yaml
⚠️ Let op: Elke deploy: false zorgt dat de chart niet zijn eigen Postgres/Valkey/ClickHouse/MinIO sub-charts installeert, maar in plaats daarvan verbinding maakt met de beheerde OVHcloud-instances. Daardoor is dit een implementatie met gemanagede services in plaats van een self-managed implementatie.
Stap 6 – Langfuse installeren
Haal het bestand deploy/langfuse/values.yaml op uit de repository en breng de benodigde wijzigingen aan:
- <uw-domein>
- <uw-postgresql-host>
- <uw-valkey-host>
- <uw-clickhouse-host>
- <uw-bucket>
Sla vervolgens de bijgewerkte values.yaml op en voer tot slot deploy/langfuse/install.sh uit:
bash deploy/langfuse/install.shDit is de laatste fase van de installatie: het vereist de namespace en het secret uit stap 2 en 5, de DNS-resolutie uit stap 4 (anders kan het TLS-certificaat niet worden uitgegeven) en de ClusterIssuer uit stap 3, die al moet bestaan.
Controleer vervolgens of het volledige implementatieproces soepel is verlopen:
kubectl -n langfuse get pods
curl -s https://langfuse.<your-domain>/api/public/health
{"status":"OK","version":"<chart appVersion>"} op het health endpoint, en beide pods Running zonder herstarts, betekent dat de stack actief is: ingress, TLS, Postgres, Valkey, ClickHouse en S3 zijn allemaal bereikbaar.
Stap 7 – Een applicatie inrichten
1. Stel de SDK in uw applicatie in
Zodra Langfuse bereikbaar is, is de verwijzing van een applicatie ernaar een kwestie van een SDK-wissel, geen rewrite. Voor een applicatie die al de openai Python SDK gebruikt voor AI Endpoints:
from dotenv import load_dotenv

 load_dotenv()  # OPENAI_API_KEY, OPENAI_BASE_URL, LANGFUSE_* must be loaded first

 from langfuse.openai import openai  # drop-in replacement for `import openai`

 client = openai.OpenAI()  # reads OPENAI_API_KEY / OPENAI_BASE_URL

 response = client.chat.completions.create(
     model="Qwen3.5-397B-A17B",
     messages=[{"role": "user", "content": "hello"}],
     stream=True,
     stream_options={"include_usage": True},
     name="chat-response",
     metadata={
         "langfuse_session_id": "session-123",
         "langfuse_user_id": "user-456",
         "langfuse_tags": ["feature:chat"],
     },
 )
⚠️ Let op: Gebruik examples/.env.example en bewerk dit .env bestand met uw eigen omgevingsvariabelen. Laad vervolgens de omgevingsvariabelen en configureer de Langfuse-client voordat u langfuse.openai importeert
.
- Voor volledige, geteste referentie-implementaties van dit patroon – met meerstapsgesprekken, sessie/gebruikers-tagging en Prompt Management voor vier verschillende gebruiksprofielen (code genereren, FAQ, documenten samenvatten, lange teksten), zie:
- examples/simulate_dev_users.py
- examples/simulate_support_users.py
- examples/simulate_analyst_user.py
examples/simulate_writer_user.py⚠️ Waarschuwing: Als u een gestreamd antwoord verbruikt, stop dan niet gelijk met itereren bij finish_reason == "stop"
. Verschillende OpenAI-compatibele providers, inclusief AI Endpoints, sturen de chunk met tokengebruik ná dat punt; voortijdig afbreken betekent dat Langfuse het nooit ziet en de kosten van de trace als nul worden weergegeven, ook al zijn er daadwerkelijk tokens verbruikt.
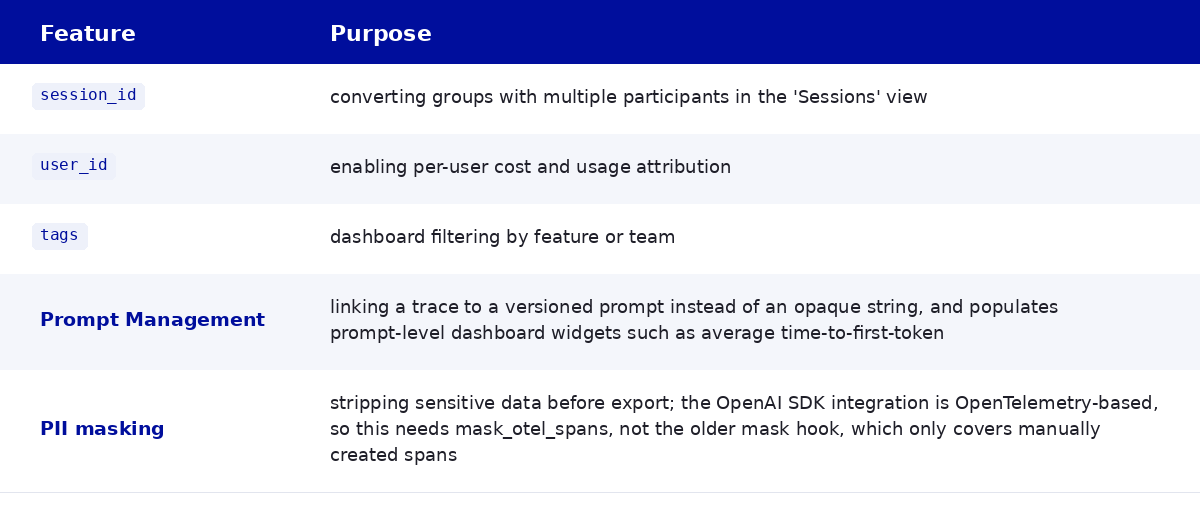
2. Kostentracking voor AI Endpoints-gebruik
Langfuse berekent de kosten per trace op basis van een tabel met modelprijzen en bevat standaard geen vermelding voor door OVHcloud gehoste modellen – elke trace toont $0 aan kosten totdat u aangeeft wat elk model kost. Dat is waar de eerder vermelde catalogus-API ("https://catalog.endpoints.ai.ovh.net/rest/v1/models_v2") voor bedoeld is: haal deze één keer op, registreer de prijs van elk model bij de Models API van Langfuse en de kostenberekening start automatisch voor elke volgende call.
import os
 import requests

 LANGFUSE_BASE_URL = os.environ["LANGFUSE_BASE_URL"]
 LANGFUSE_PUBLIC_KEY = os.environ["LANGFUSE_PUBLIC_KEY"]
 LANGFUSE_SECRET_KEY = os.environ["LANGFUSE_SECRET_KEY"]

 catalog = requests.get(
     "https://catalog.endpoints.ai.ovh.net/rest/v1/models_v2"
 ).json()

 for model in catalog:
     pricing = model.get("metadata", {}).get("usage_information", {}).get("pricing")
     if not pricing:
         continue
     prices = {
         {"million_input_tokens": "inputPrice", "million_output_tokens": "outputPrice"}[p["price_unit"]]: p["price"] / 1_000_000
         for p in pricing
         if p["price_unit"] in ("million_input_tokens", "million_output_tokens")
     }
     if not prices:
         continue
     requests.post(
         f"{LANGFUSE_BASE_URL}/api/public/models",
         auth=(LANGFUSE_PUBLIC_KEY, LANGFUSE_SECRET_KEY),
         json={
             "modelName": f"ovh-ai-endpoints/{model['id']}",
             "matchPattern": f"(?i)^({model['name']})$",
             "unit": "TOKENS",
             **prices,
         },
     )
Dit is een eenmalige API-call, geen script dat in dit repository wordt bewaard: zodra de prijs van een model is geregistreerd, staat deze in Langfuse zelf en kan elke client deze daar vinden. Zie examples/README.md voor de volledige onderbouwing, inclusief waarom prijzen in euro's worden weergegeven ondanks dat Langfuse een $ gebruikt.
Zodra er een overeenkomstige prijsdefinitie bestaat, verschijnen de kosten onmiddellijk bij nieuwe traces.
Bij een echte call naar Qwen3.5-397B-A17B:
- 28 invoertokens (€ 0,60 per miljoen tokens)
- 1430 uitvoertokens (€ 3,60 per miljoen tokens)
De calculatedTotalCost van Langfuse kwam precies uit op: 28 * 0,0000006 + 1430 * 0,0000036 = € 0,0051648
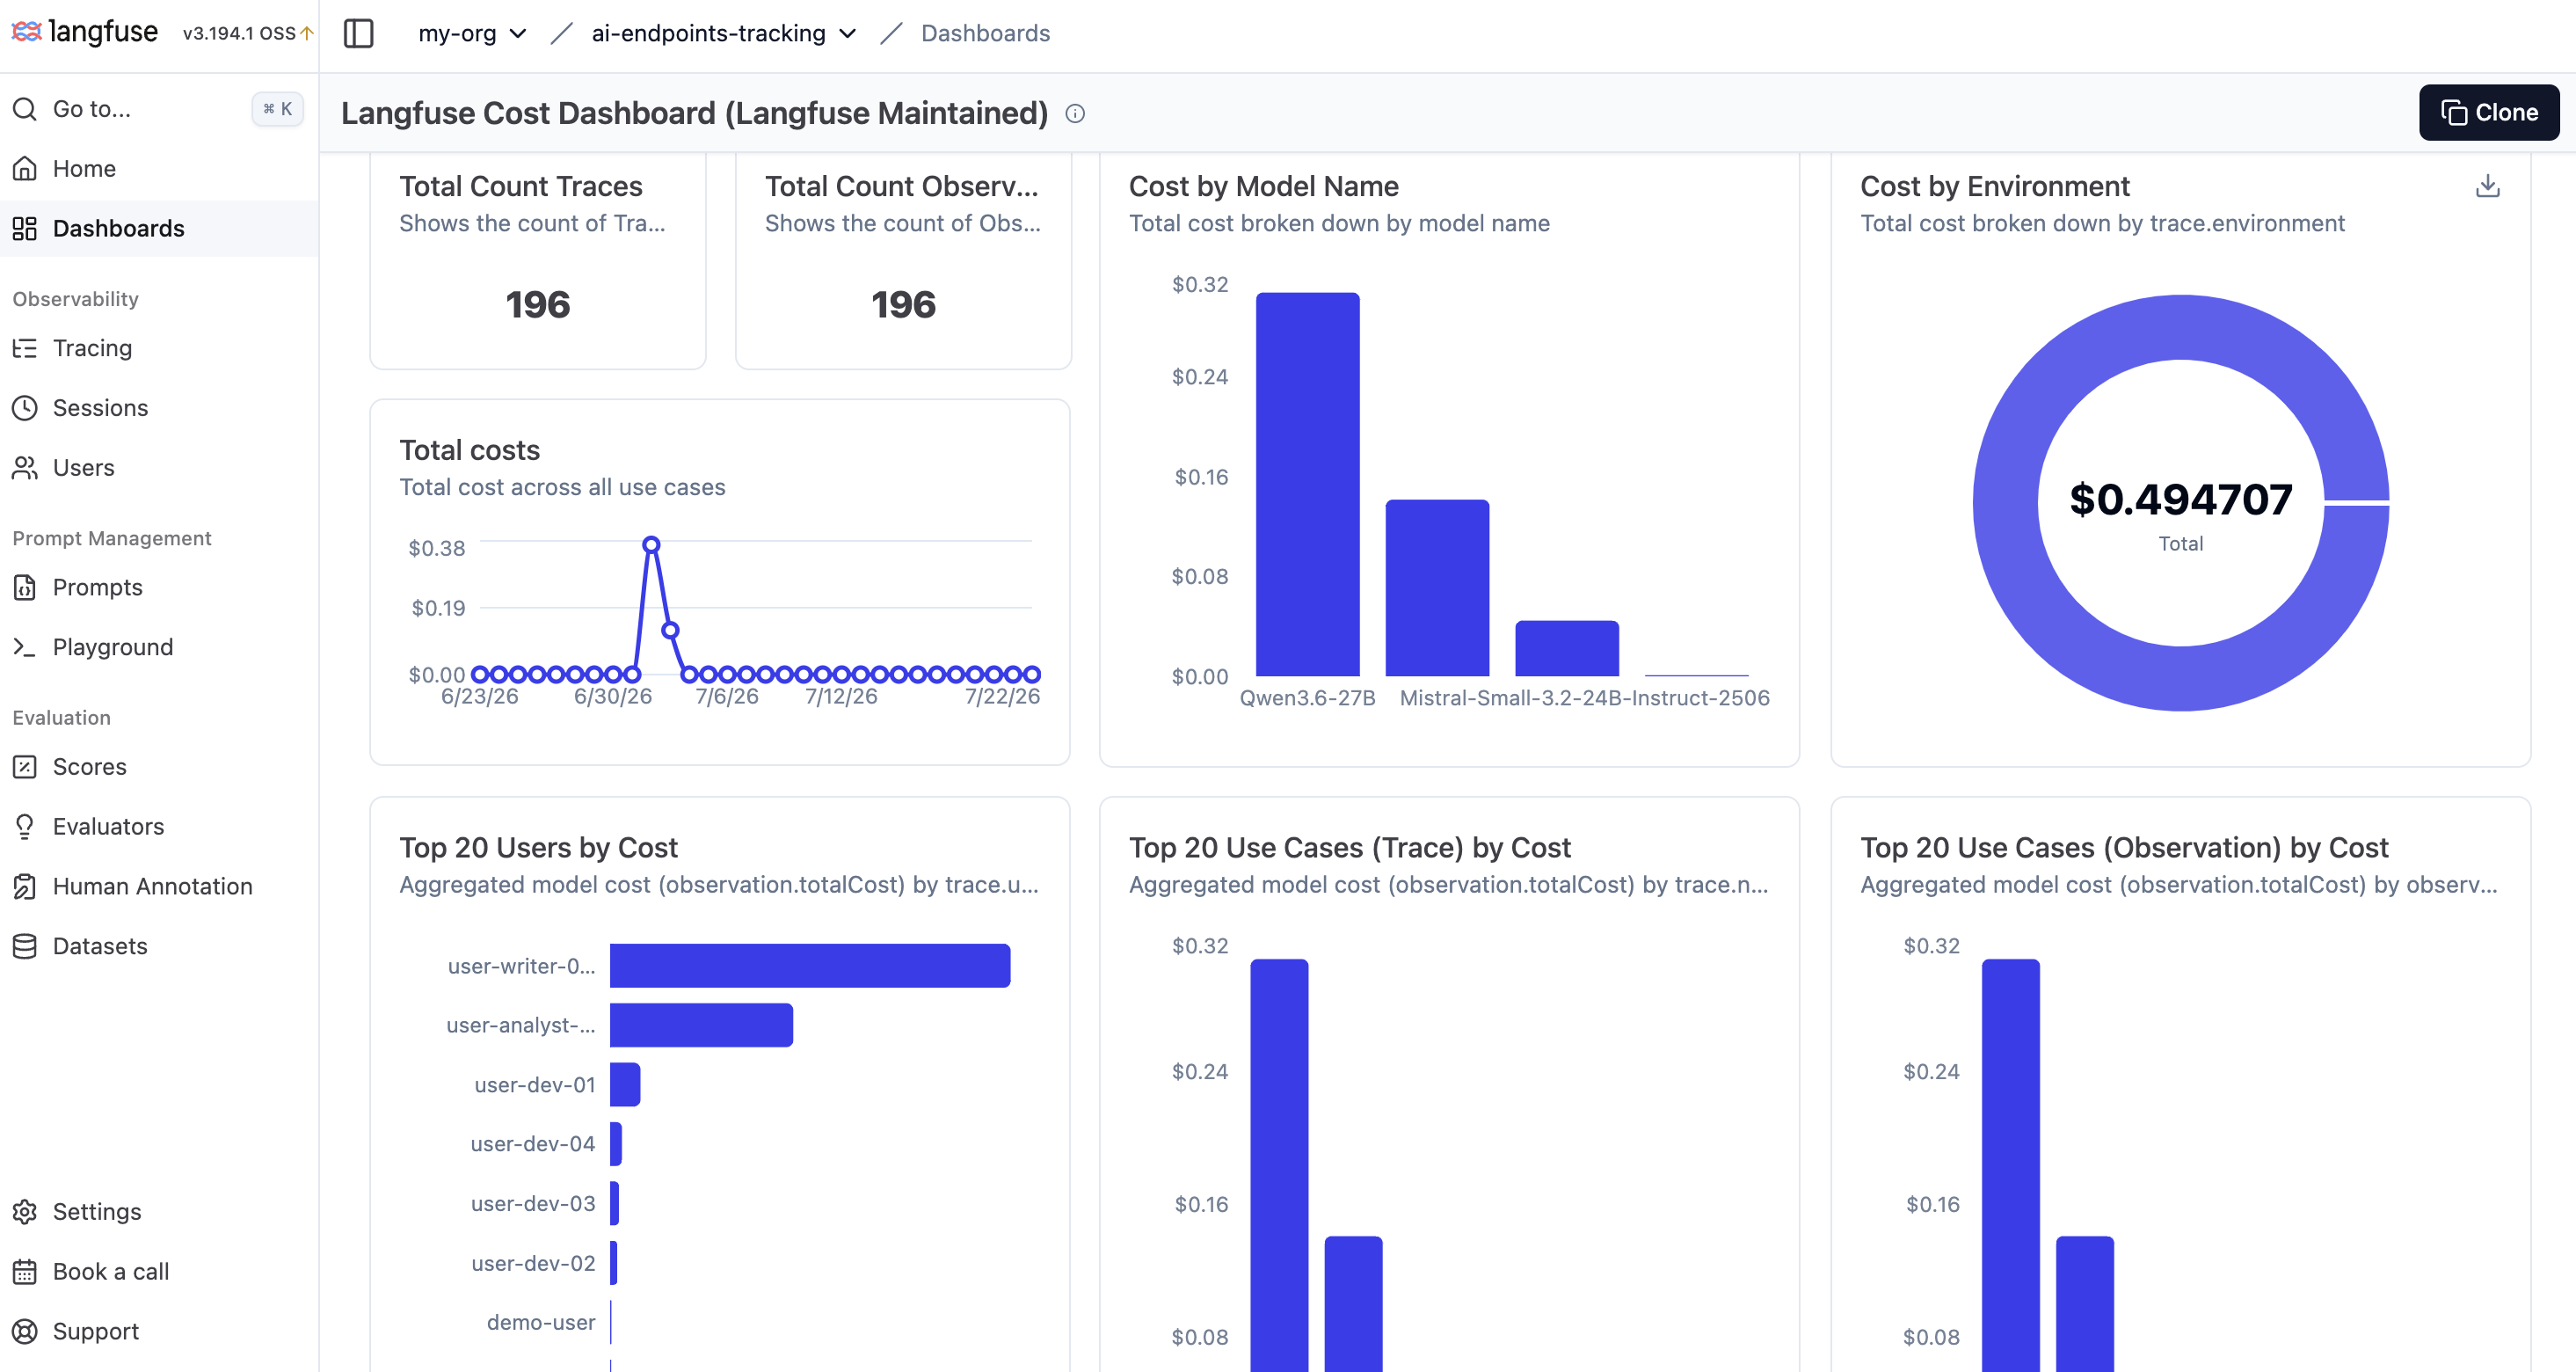
Kostendashboard van Langfuse
⚠️ Let op: Langfuse geeft kosten altijd weer met een $-teken; er is geen valuta-instelling per project. Als de geïmporteerde prijstabel in euro's is, zoals bij de prijzen van OVHcloud AI Endpoints, dan is elk getal in de Langfuse UI een eurobedrag, weergegeven met een dollarteken.
U kunt ook de verschillende metrics voor model-latency controleren:
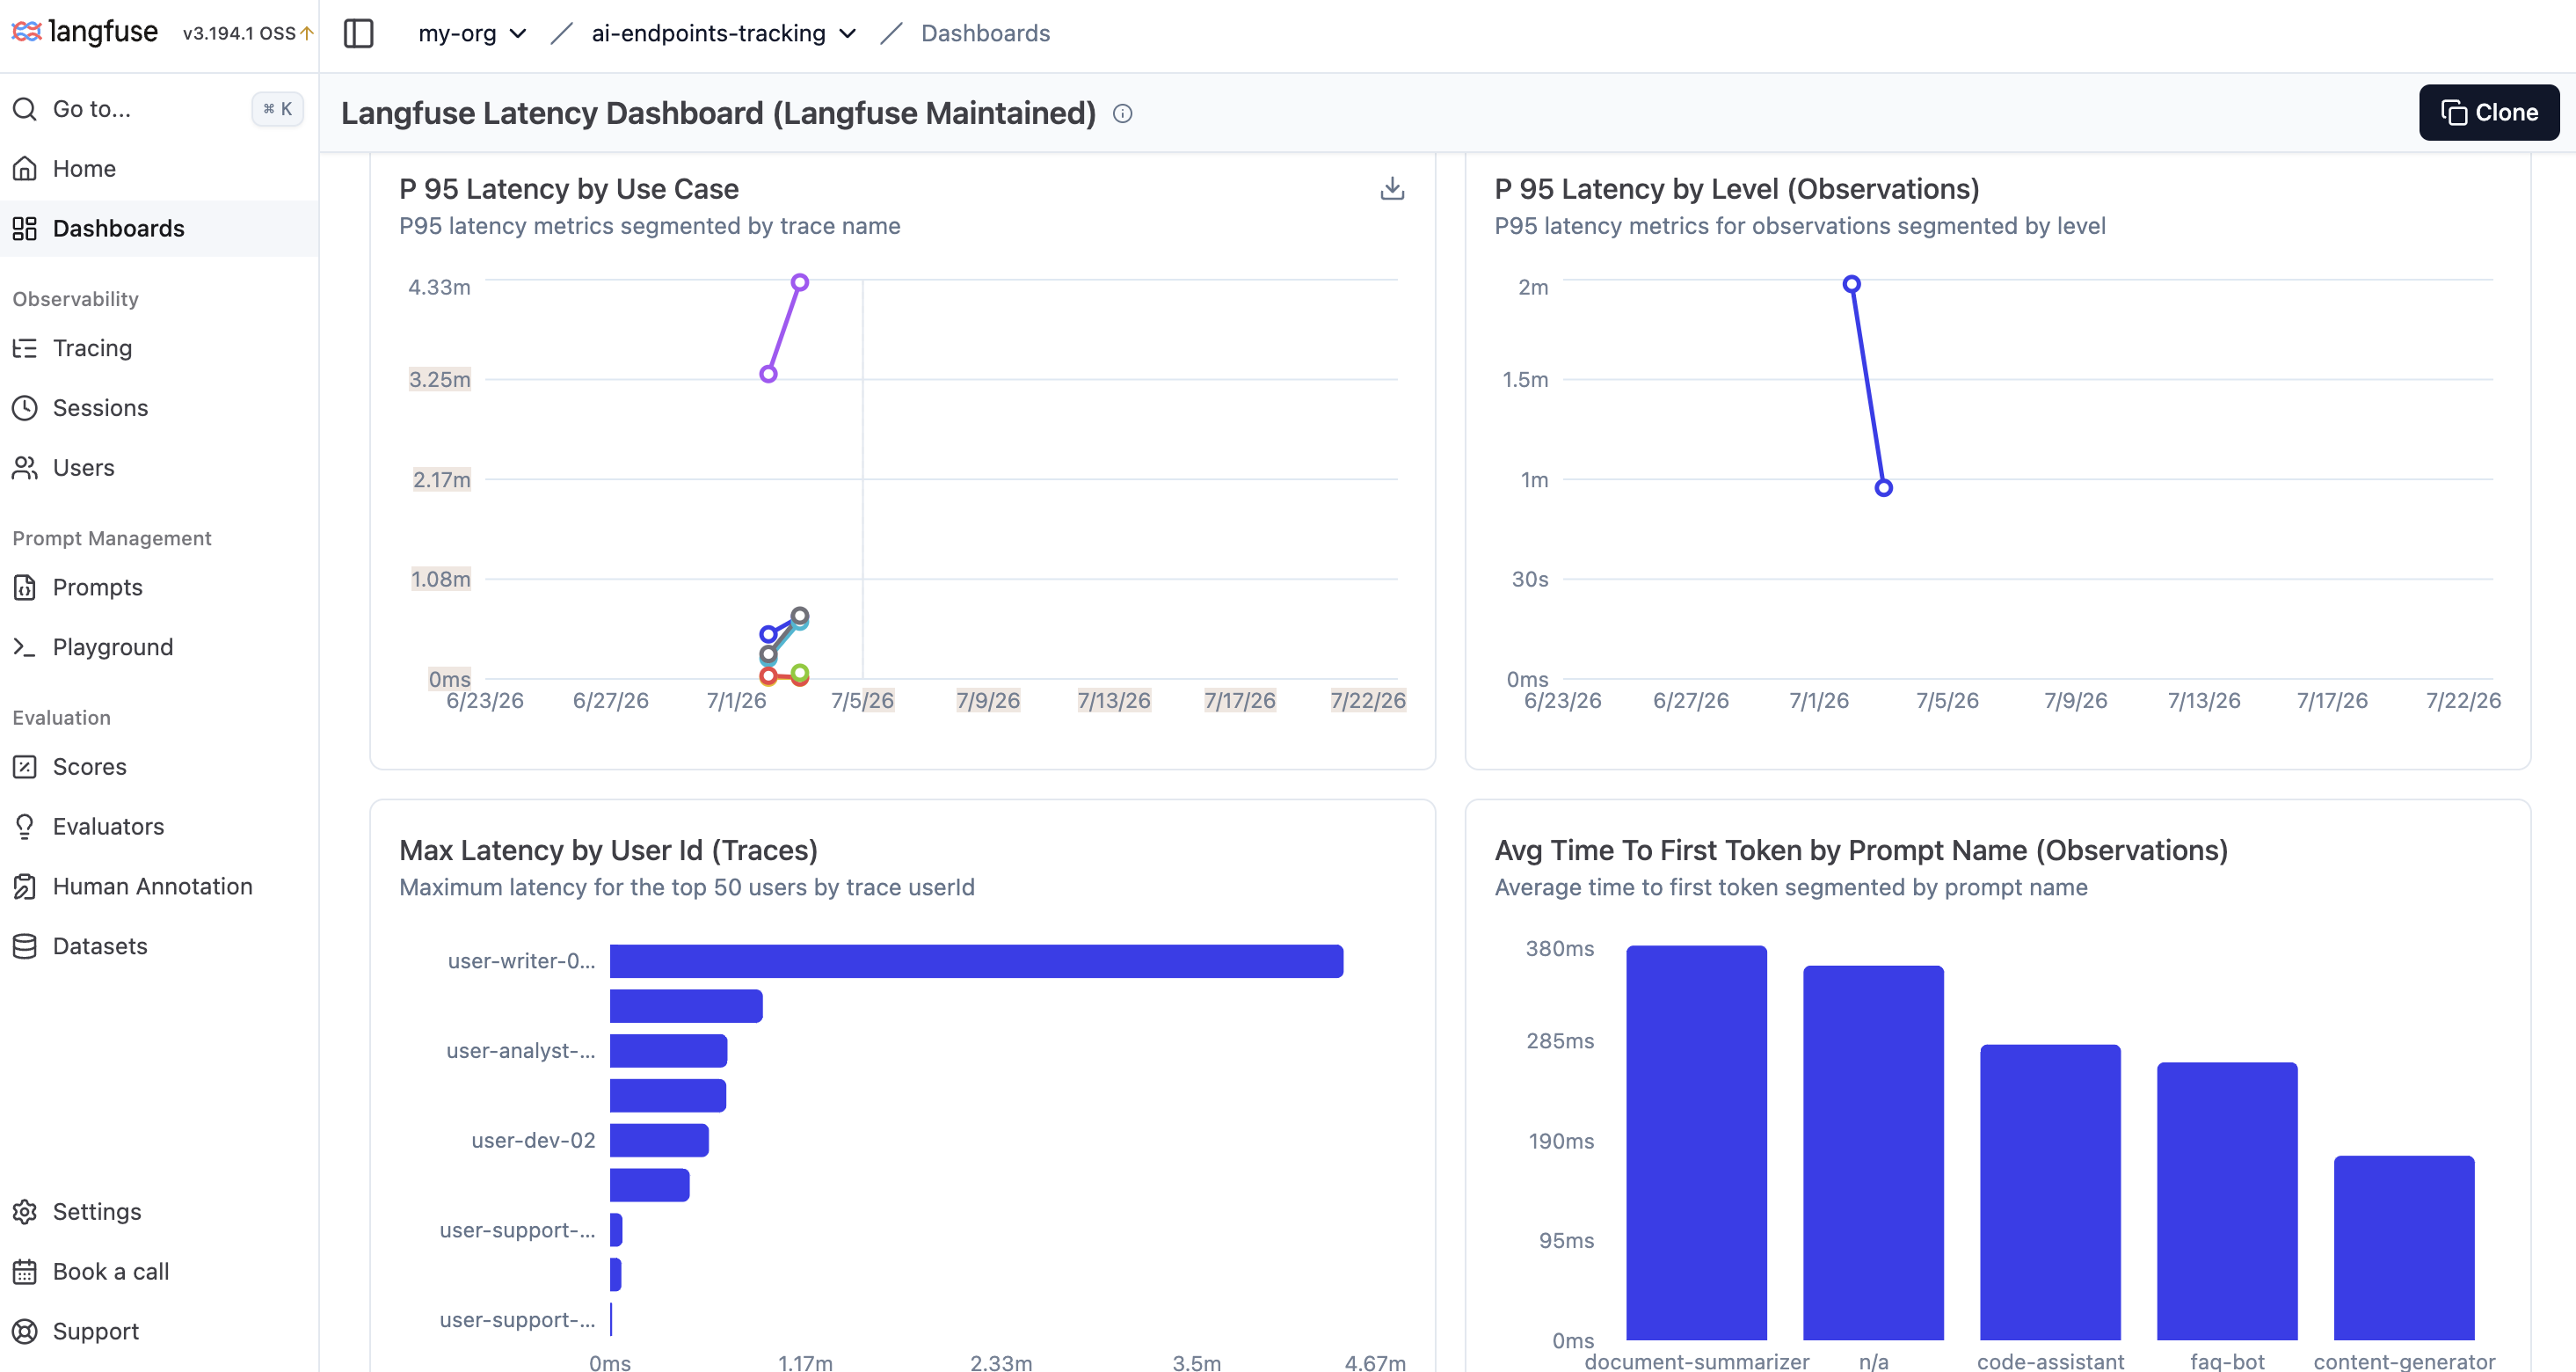
Latencydashboard van Langfuse
Ga nog een stap verder en analyseer de traces voor calls of handelingen.
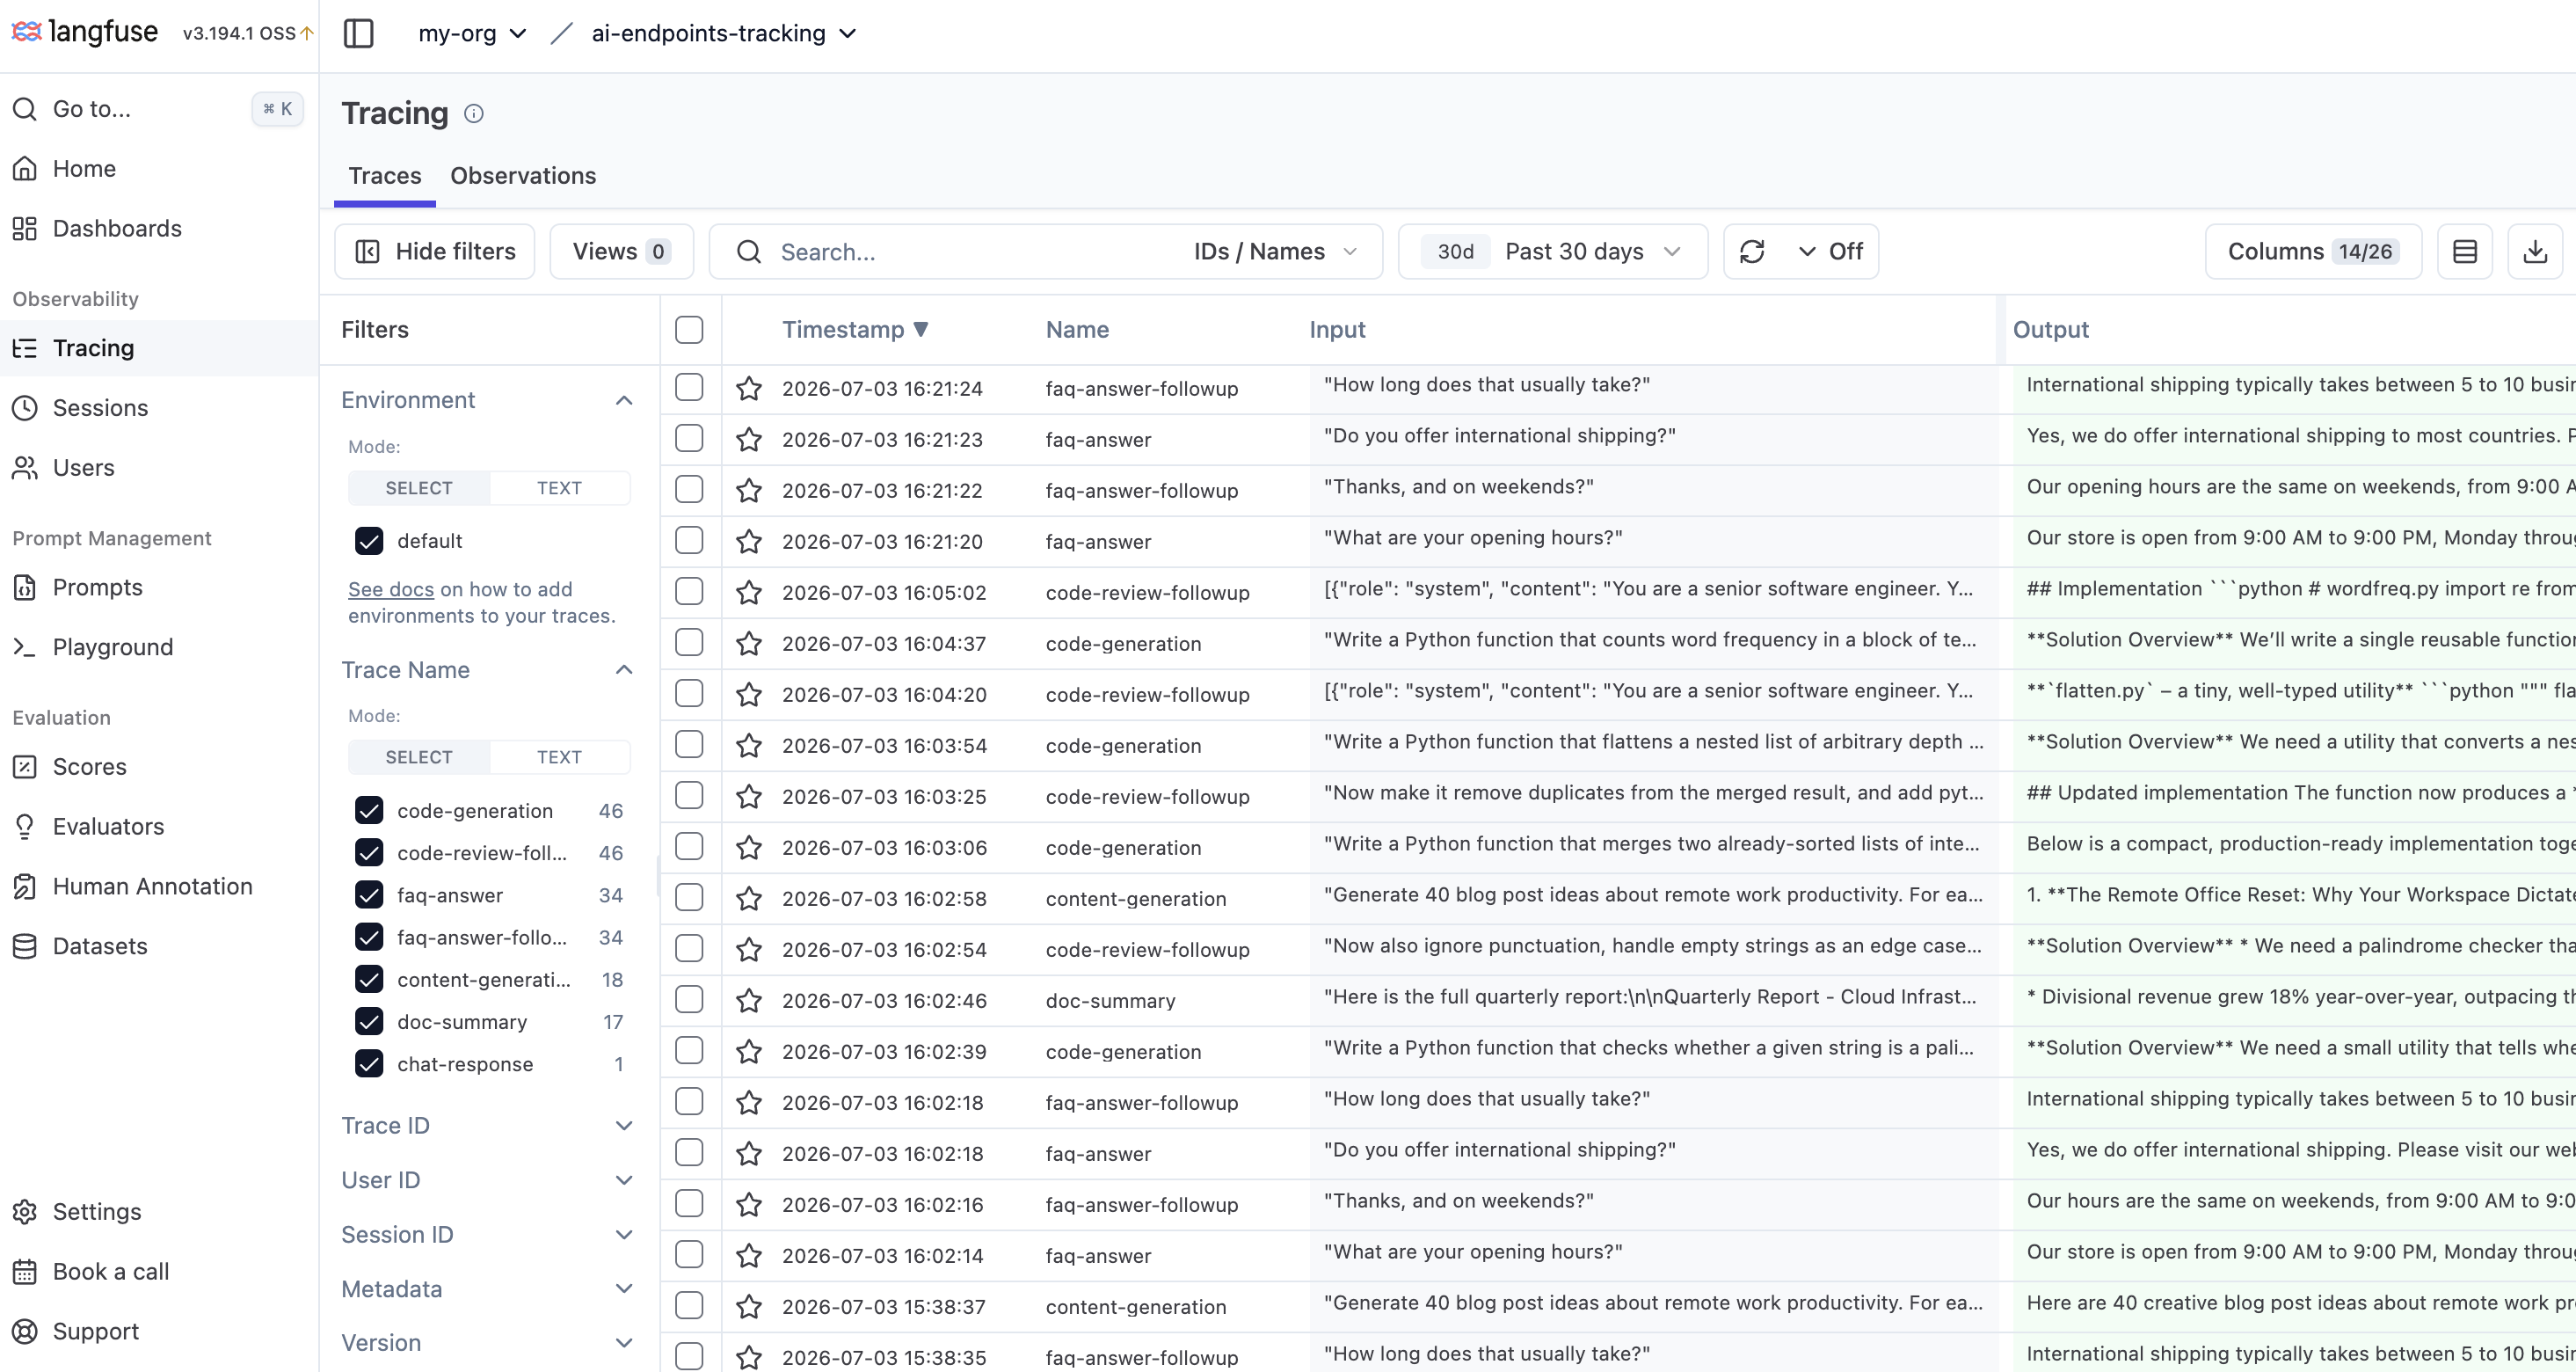
Tracingvoorbeeld van Langfuse
Gefeliciteerd! U heeft nu toegang tot alle features van Langfuse in een gecontroleerde omgeving.
Verdergaan
- High availability: deze architectuur draait één web- en één worker-replica, wat voldoende is om de set-up te valideren, maar geen ruimte laat voor een pod-uitval zonder downtime. Verhoog bij een publieke implementatie het aantal replica's naar 2 of meer voor web en voeg een PodDisruptionBudget toe dat hierop is afgestemd – een configuratie voor slechts één replica beschermt niets.
- Automatisch schalen: noch HPA, noch KEDA is standaard ingeschakeld; schakel er een in als het aanvraagvolume onvoorspelbaar is.
- Meldingen voor kosten: dezelfde modellen-API die werd gebruikt om prijzen in te voeren, kan via de metrics-API van Langfuse worden bevraagd om geautomatiseerde kostenmeldingen per team of functie op te stellen, in plaats van handmatig dashboards te controleren.
- Netwerkbeleid: er is in deze configuratie niets gedefinieerd; overweeg om uitgaand verkeer vanuit de Langfuse-namespace te beperken tot alleen de noodzakelijke gemanagede service-endpoints.
Conclusie
Deze architectuur levert u een Langfuse-implementatie die:
- Draait op OVHcloud MKS zonder zelfbeheerde databases – Postgres, Valkey, ClickHouse en Object Storage zijn allemaal gemanagede services van OVHcloud
- Beëindigt TLS automatisch via Traefik en cert-manager, waarbij certificaten zonder handmatige interventie worden vernieuwd
- Legt door een SDK-wijziging van twee regels volledige traces vast, inclusief tokengebruik en latency, van elke applicatie die OVHcloud AI Endpoints aanroept
- Wijst kosten toe per model, per gebruiker en per sessie, met gebruik van de eigen catalogusprijzen van AI Endpoints in plaats van te raden
- Bewaart alle prompts, voltooiingen en kosten binnen een infrastructuur waarover u controle heeft