Chaque base de données managée que nous exploitons commence sa vie sous la forme d’une image Docker. Voyez-la comme un appartement meublé : Debian pour les murs, le moteur de base de données pour les meubles et quelques outils maison OVHcloud pour la plomberie. Vous emménagez, nous nous occupons de l’entretien.
Seul problème ? Les meubles changent sans arrêt. MariaDB, MySQL (Percona Server), PostgreSQL et Valkey publient de nouvelles versions tout au long de l’année. Chacune apporte son lot de corrections de bugs, de correctifs de sécurité et parfois de surprises.
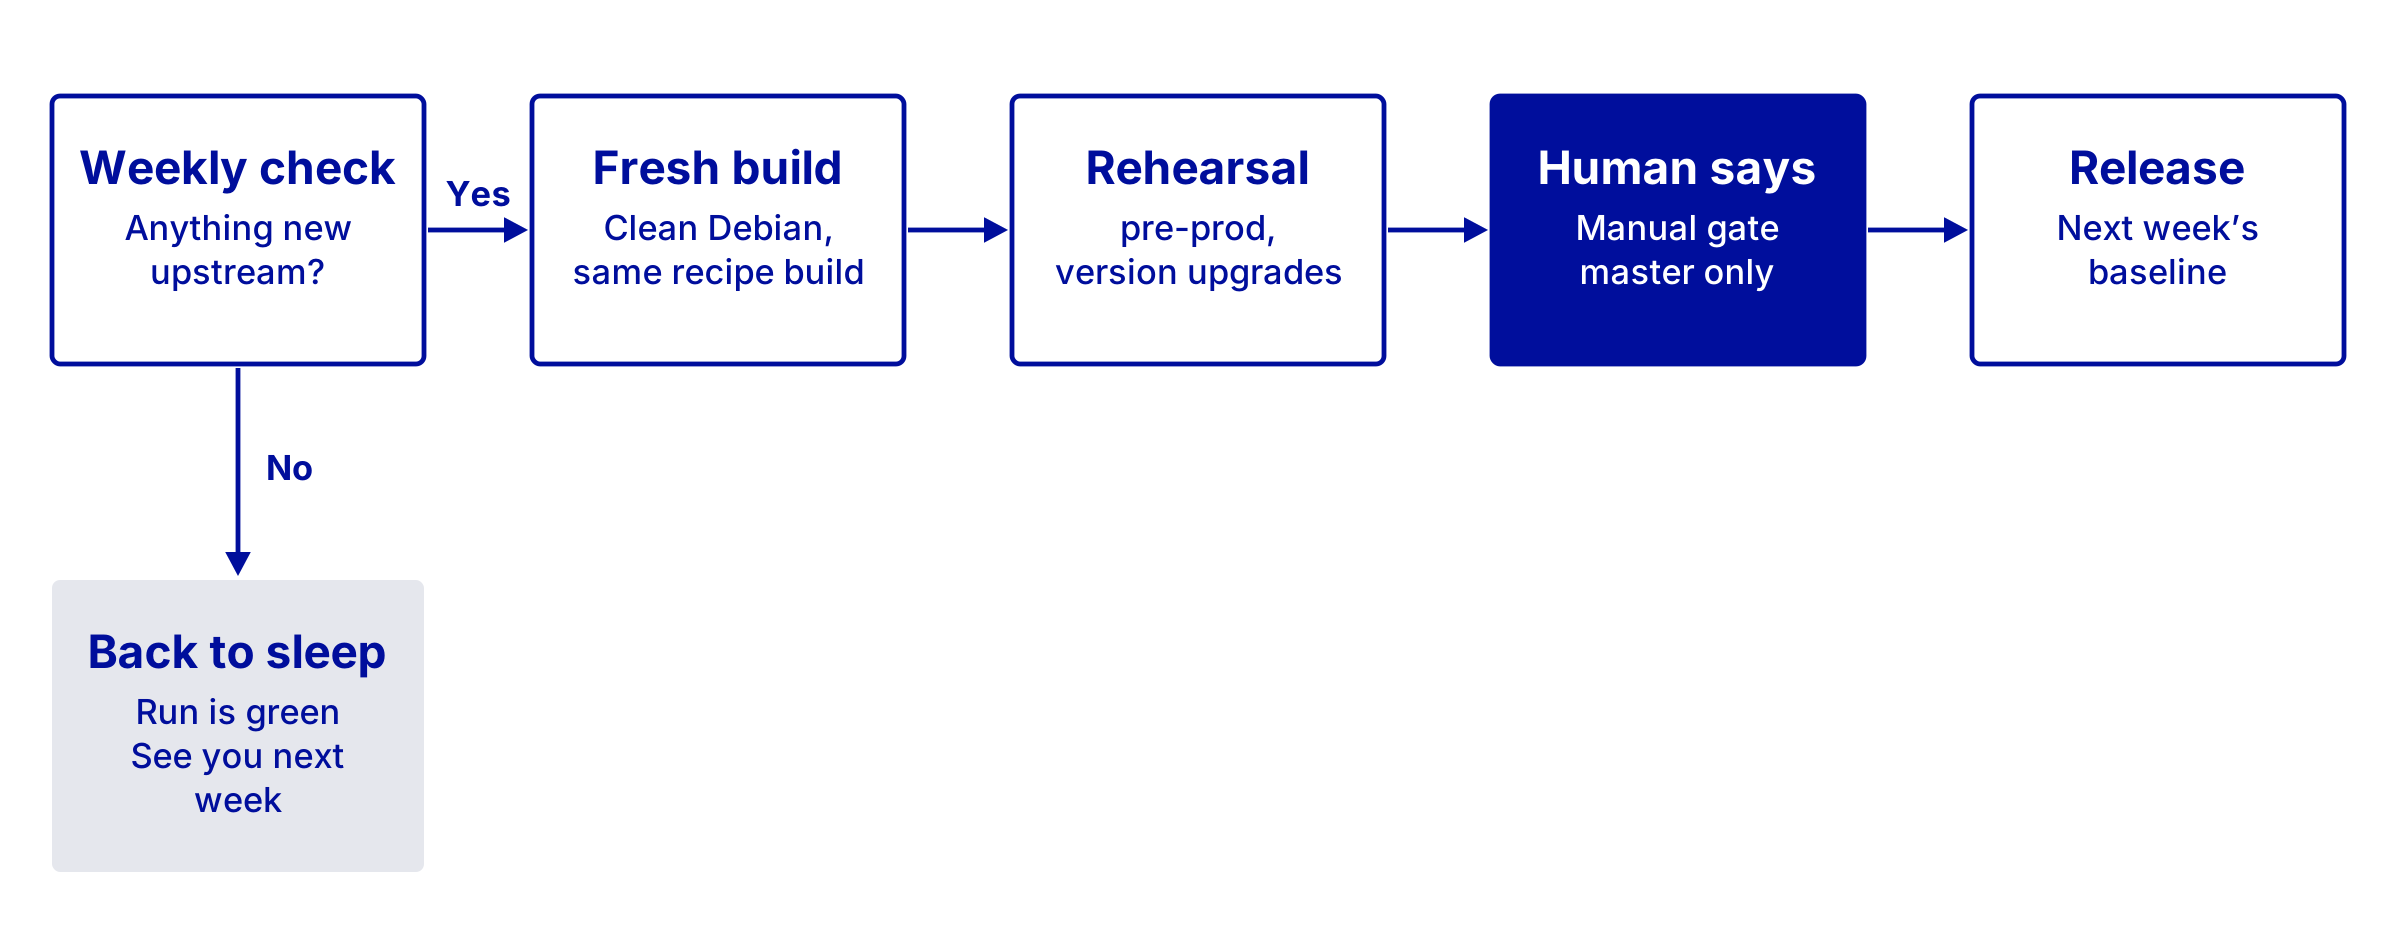
Nous avons donc conçu Emile, une usine qui garde les images de bases de données à jour. Chaque semaine, Emile vérifie 15 couples moteur/version, reconstruit ce qui doit l’être, le fait répéter puis attend qu’un humain donne son feu vert. Suivons-le pendant une semaine.
Du nouveau cette semaine ?
Chaque semaine, chaque couple moteur/version dispose de son propre créneau dans CDS, notre plateforme CI/CD open source. Les 15 workflows partagent un template unique. Chacun ne contient qu’une ligne cron et six paramètres (moteur, version, release Debian, etc.).
Le premier job, celui de version, pose une seule question : le dernier paquet publié par l’éditeur est-il déjà en production ?
- Il interroge le dépôt apt de l’éditeur pour connaître le paquet candidat le plus récent. Valkey étant compilé depuis les sources, c’est GitHub qu’il consulte dans ce cas.
- Il en déduit un tag d’image, qui associe la version du paquet à la version mineure de Debian sur laquelle l’image sera construite.
- Il cherche ensuite ce tag dans notre registre de production.
Le tag existe ? Rien à faire. Le job se rendort et l’exécution se termine au vert. La plupart des semaines, l’histoire s’arrête là. C’est exactement ce que nous voulons. Le build le moins coûteux est celui qu’on évite. Rien n’est reconstruit pour le principe.
Tag manquant ? Le build démarre.
Tout reconstruire de zéro
Nous ne corrigeons jamais une ancienne image. Chaque build part d’une image Debian vierge et suit la même recette, écrite noir sur blanc. Cette recette comporte deux couches.
Packer définit l’enveloppe de l’image. Un seul template sert à construire tous les moteurs. Il lance un conteneur Debian, le provisionne puis le fige (commit) avec partout le même entrypoint, le même healthcheck et les mêmes labels. Seuls les ports exposés et les volumes varient d’un moteur à l’autre.
Ansible s’occupe de l’intérieur. Un rôle de base installe le socle commun à toutes les images : locales, fuseau horaire, supervisord comme processus init du conteneur… Le rôle propre au moteur prend ensuite le relais (MariaDB, Percona, PostgreSQL ou Valkey). Chacun suit les mêmes étapes :
- ajouter le dépôt de l’éditeur et sa clé de signature ;
- installer le moteur ;
- le configurer, puis déposer le script de démarrage et le healthcheck.
Prendre en charge une nouvelle version majeure revient pour l’essentiel à ajouter un fichier de variables et un workflow hebdomadaire. La recette, elle, ne bouge pas. Tout l’intérêt est là.
La répétition générale
Une image fraîchement construite ne part pas en production. Elle atterrit d’abord dans un registre de snapshots. Ce snapshot monte ensuite sur scène en préproduction, comme lors d’une répétition générale avant le soir de la première.
Et nous ne nous contentons pas de vérifier qu’il démarre. Nous faisons aussi répéter les parcours que suivent les vraies instances : la montée depuis la version en service vers la nouvelle, puis le passage d’une version majeure à l’autre d’une même base de données. Au moindre accroc, la nouvelle image reste en coulisses.
Un humain donne son feu vert
Comme on aime le dire chez nous, un bon sysadmin est un sysadmin qui ne fait rien. Les machines abattent donc presque tout le travail. Presque. Le job de release attend derrière un verrou manuel, qui ne s’ouvre que sur la branche master. Un membre de l’équipe appuie sur le bouton et l’image passe du statut de snapshot à celui de release.
Les machines reprennent alors la partie ingrate : chaque jour, 5 % de notre parc de production bascule sur la nouvelle image. L’ordre est tiré au hasard entre les clients, si bien que rien ne permet de prévoir quand une instance donnée sera migrée.
Cette image promue sert aussi de référence pour la semaine suivante, puisque c’est son tag que le job version ira chercher. La boucle est bouclée.
Quand le scénario déraille
Automatiser est facile quand tout se passe comme prévu. Voici ce qui arrive quand ce n’est pas le cas :
Un paramètre par défaut change sans prévenir : chaque rôle moteur conserve une copie de la configuration par défaut d’origine de l’éditeur, telle que nous l’avons relue. Après l’installation, le build compare les deux. À la moindre différence, il échoue volontairement. Un humain lit le diff, vérifie ce qui compte et le reporte dans notre configuration, met à jour la référence, puis relance l’usine. Aucune surprise n’arrive en production sans avoir été lue.
Un tag n’est pas une release : il arrive que Valkey pousse un tag git avant que la release soit réellement publiée. Emile n’accorde donc sa confiance à une version qu’une fois celle-ci mentionnée dans les notes de version. Pas de notes de version, pas de build.
GitHub demande de lever le pied : au départ, nous listions les versions de Valkey via l’API REST de GitHub. Les appels anonymes sont limités à 60 requêtes par heure et par IP et nos workers CI passent tous par la même sortie vers Internet. Les opérations manuelles ont atteint cette limite trois fois en une semaine. Le processus hebdomadaire automatisé n’y était pour rien, mais nous l’avons tout de même adapté. Par défaut, l’API ne renvoie en outre que 30 releases par page, un peu juste pour couvrir toutes les versions de Valkey depuis la 7.2 jusqu’à la plus récente. Nous lisons désormais les tags avec git ls-remote, ce qui règle les deux problèmes dans notre configuration.
Un correctif maison s’impose : pas de nouvelle version de la base de données, mais la plomberie a besoin d’une réparation. Quand la vérification hebdomadaire ne trouve rien de nouveau, le job de build est sauté, tout en restant lançable à la main. Un clic suffit pour reconstruire l’image sur la base corrigée. Elle passe toujours par la même répétition et la même validation humaine.
Des bases de données à jour : ce que cela change pour vous
Le secret d’Emile n’a rien de sophistiqué. Il tient en une question peu coûteuse, posée chaque semaine et automatisée pour alléger notre charge de travail.
Concrètement, pour vous :
- à jour sans effort : nous recherchons les nouvelles versions chaque semaine et les mises à jour mineures s’appliquent automatiquement.
- reconstruites à neuf à chaque fois : un système propre et la même recette, sans aucun vestige du passé.
- testées avant d’être livrées : les montées de version sont d’abord éprouvées en préproduction.
- validées par une personne : rien n’est mis en ligne simplement parce qu’un script s’est terminé.
Quelques chiffres sur ce cas d’usage ? 15 workflows hebdomadaires, cinq moteurs différents (les quatre cités plus haut, plus sharedsql, les bases de données fournies avec nos hébergements web), un seul template Packer et un seul humain pour appuyer sur « release ».
Vous souhaitez que vos bases de données restent à jour sans y penser ? Découvrez Web Cloud Databases.